TLDR
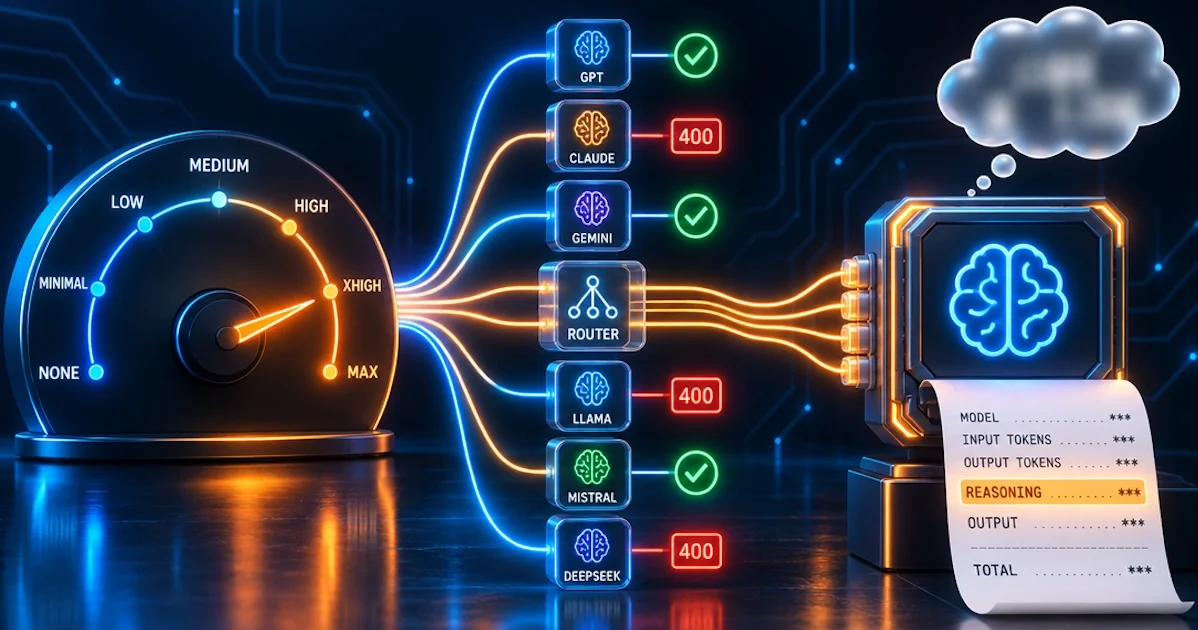
Jeder Anbieter versteht unter „Reasoning Effort" etwas anderes. Von sieben üblichen Werten akzeptierten die Modelle zwischen zwei und sieben; abgelehnte Werte enden mit HTTP 400. Router nehmen oft alles an – auch Werte, die der Anbieter dahinter ablehnt. Das Denken selbst wird immer als Output bezahlt, auch wenn man es nicht zu sehen bekommt. Teil 2 der Serie „Was ein LLM-Aufruf wirklich kostet".
Einleitung
Reasoning-Modelle „denken" vor der Antwort, und man kann ihnen sagen, wie gründlich. Das klingt nach einem einfachen Regler: wenig Denken für einfache Fragen, viel Denken für schwere. In der Praxis heißt der Regler bei jedem Anbieter anders, hat andere Stufen und reagiert unterschiedlich auf Werte, die er nicht kennt.
Für eine Anwendung, die mehrere Anbieter anspricht, ist das mehr als eine Stilfrage: Ein falscher Wert ist ein Fehler zur Laufzeit – oder, schlimmer, er wird still ignoriert.
1. Der Parameter-Zoo
| Anbieter | Parameter | Werte laut Doku |
|---|---|---|
| OpenAI (Responses) | reasoning.effort |
none bis max, je Modell verschieden |
| OpenAI (Chat Completions), xAI Chat, Router | reasoning_effort |
je Anbieter |
| Anthropic | output_config.effort |
low, medium, high, xhigh, max |
| Gemini 3 / 4 | thinkingLevel |
low, medium, high (je Modell mehr) |
| Gemini 2.5 | thinkingBudget |
Tokenzahl, 0 = aus |
| Open-Source-Modelle | enable_thinking, thinking, reasoning_effort |
je Hoster |
Gemini lehnt thinkingLevel und thinkingBudget in derselben Anfrage ab. Das alte budget_tokens von Anthropic beantworteten alle drei getesteten Claude-Modelle mit HTTP 400.
2. Was angenommen wird
Wir haben eine kleine Denkaufgabe (die klassische „Schläger und Ball"-Frage) mit jedem der sieben Werte an jedes Modell geschickt. In der Tabelle steht, ob der Wert angenommen wurde, und dahinter die gemeldeten Reasoning-Tokens:
| Modell | none | minimal | low | medium | high | xhigh | max |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Sol | ✗ | ✗ | ✓ 11 | ✓ 14 | ✓ 13 | ✓ 34 | ✓ 68 |
| GPT-5.6 Luna (Responses) | ✓ 0 | ✗ | ✓ 0 | ✓ 17 | ✓ 23 | ✓ 23 | ✓ 45 |
| gpt-5-mini | ✗ | ✓ 0 | ✓ 64 | ✓ 128 | ✓ 320 | ✗ | ✗ |
| Claude Sonnet 5.5 | ✗ | ✗ | ✓ 0 | ✓ 0 | ✓ 0 | ✓ 0 | ✓ 107 |
| Claude Haiku 5.5 | ✗ | ✗ | ✓ 0 | ✓ 0 | ✓ 50 | ✓ 53 | ✓ 172 |
| Grok 4.7 | ✗ | ✓ 251 | ✓ 190 | ✓ 233 | ✓ 413 | ✓ 318 | ✗ |
| Gemini 3.8 Flash | ✗ | ✗ | ✓ 72 | ✓ 256 | ✓ 266 | ✗ | ✗ |
| Mistral Medium | ✓ 0 | ✗ | ✗ | ✗ | ✓ 306 | ✗ | ✗ |
| gpt-oss-120b bei IONOS | ✗ | ✗ | ✓ 12 | ✓ 134 | ✓ 200 | ✗ | ✗ |
| Claude Sonnet 5 über Cortecs | ✓ 0 | ✓ 0 | ✓ 0 | ✓ 0 | ✓ 0 | ✓ 0 | ✓ 61 |
✓ angenommen (Reasoning-Tokens), ✗ HTTP 400. Einzelaufrufe vom 19.10.2026; die Tokenzahlen schwanken von Aufruf zu Aufruf.
Was auffällt:
- OpenAI ist je Modell verschieden: GPT-6.1 Sol lehnt
noneundminimalab, gpt-5-mini lehntxhighundmaxab. - Anthropic lehnt
noneundminimalab und hat als einziger Direktanbietermax. Bei Sonnet 5 und 5.5 entstand für unsere Aufgabe bisxhighkein einziges Reasoning-Token, erstmaxdachte nach. Der Effort ist bei Claude eine Obergrenze, kein Auftrag. - xAI lässt sich nicht abschalten;
nonewird abgelehnt. - Gemini 3.8 Flash akzeptiert nur
low,mediumundhigh– und denkt ohne Vorgabe so viel wie beihigh. Das Denken meldet Gemini alsthoughtsTokenCount. - Mistral akzeptierte nur
noneundhigh. - IONOS lehnte für Qwen3.8-27B den Wert
highab,xhighdagegen nicht. Logik ist bei Hostern offenbar optional.
3. Router nehmen alles an
Cortecs akzeptierte alle sieben Werte für Claude, darunter none und minimal, die Anthropic direkt ablehnt. Auch EU Router nahm für Claude jeden Wert an. Was der Router daraus macht, bleibt unsichtbar: Cortecs dokumentiert eine Übersetzung in Thinking-Budgets von 1 024 bis 4 096 Tokens, die sich an den Antworten nicht ablesen lässt (nicht messbar). Requesty meldet für Claude überhaupt keine Reasoning-Tokens.
Ein Router, der jeden Wert annimmt, verhindert Fehler zur Laufzeit. Er verhindert aber auch, dass Sie merken, wenn Ihr Wert nicht ankommt. Über EU Router dachte gpt-oss-120b in unserem Einzelaufruf bei high sogar weniger als bei low.
4. Verborgenes Denken, voll bezahlt
Reasoning-Tokens werden als Output berechnet – und Output ist das Teuerste an einem Aufruf (bei Claude Sonnet 5 fünfmal so teuer wie Input). Gezeigt wird das Denken dagegen selten:
- OpenAI zeigt die Reasoning-Tokens nicht; gpt-5-mini berechnete 256 davon für eine Antwort von acht Zeichen.
- Claude Haiku 5.5 berechnete 53 Thinking-Tokens, ohne eines davon anzuzeigen.
- Wer also nur die sichtbare Antwort zählt, unterschätzt die Kosten systematisch.
Tipp: Lesen Sie die Reasoning-Felder aus der Usage und protokollieren Sie sie getrennt. Nur so sehen Sie, ob ein höherer Effort den Aufruf tatsächlich teurer macht.
5. Effort und Cache
Ein Wechsel des Thinking-Levels kostet bei OpenAI, xAI, Gemini, Claude Sonnet 5 und den Open-Source-Modellen den Prompt-Cache – nur Claude Sonnet 5.5 und Haiku 5.5 behalten ihn. Details dazu in Teil 1. Für die Architektur heißt das: Den Effort pro Gespräch festlegen, nicht pro Nachricht.
6. So haben wir es in .NET gelöst
Evanto.ChatClients kennt genau einen Effort-Wortschatz – none, low, medium, high, xhigh, max – und übersetzt ihn pro Anbieter. Für Claude wird aus none ein low, weil die aktuellen Modelle Denken nicht abschalten lassen:
private static String? ToAnthropicEffort(ReasoningEffort effort) => effort switch
{
    ReasoningEffort.None      => "low",
    ReasoningEffort.Low       => "low",
    ReasoningEffort.Medium    => "medium",
    ReasoningEffort.High      => "high",
    ReasoningEffort.ExtraHigh => "xhigh",
    _                         => null
};
Quelle: ToAnthropicEffort (Auszug)
max gibt es nur bei Anthropic und wird für andere Anbieter mit einer Warnung im Log verworfen. In CompanyWizard bietet die Admin-Oberfläche pro Modell nur die Stufen an, die der Modellkatalog für dieses Modell kennt.
Lesson Learned: Ein grüner Verbindungstest sagt nichts darüber, ob der Anbieter Ihren Effort akzeptiert – der Test schickt keinen. Ein abgelehnter Wert zeigt sich deshalb erst im ersten echten Chat – als HTTP 400 mit dem Text des Anbieters.
7. Was bewusst offen blieb
- Qualität: Wir haben gemessen, was angenommen und berechnet wird, nicht, ob die Antworten besser werden.
- Streuung: Reasoning-Tokens schwanken von Aufruf zu Aufruf; die Tabelle zeigt Einzelaufrufe.
- OpenRouter vereinheitlicht die Werte nicht vollständig: Für Claude nahm es alle sieben an, für gpt-oss-120b lehnte es
noneab.
Fazit: übertragbare Patterns
- Effort-Werte pro Modell pflegen, nicht pro Anbieter – selbst OpenAI ist uneinheitlich.
- Abgelehnte Werte abfangen: HTTP 400 mit einer Meldung wie „not supported" ist ein Konfigurationsfehler, kein Netzwerkproblem.
- Router-Antworten prüfen: Angenommen heißt nicht weitergegeben.
- Reasoning-Tokens getrennt protokollieren, denn sie stecken im teuren Output.
- Den Effort pro Gespräch festlegen, um den Cache nicht zu verlieren.
Alle Rohdaten und Skripte: github.com/evanto-media-ag/llm-caching-reasoning-costs
Die Serie
- Teil 1: Prompt Caching im Vergleich – was den Cache trägt und was ihn bricht
- Teil 2: Thinking-Level im Vergleich – sieben Werte, zwölf Interpretationen
- Teil 3: Kostentransparenz – Formeln, Feldnamen, Preisquellen
- Teil 4: Router im Vergleich – Cortecs, EU Router, Requesty, OpenRouter
Referenzen
- OpenAI: Reasoning
- Anthropic: Effort
- xAI: Reasoning
- Google: Gemini Thinking
- Cortecs: Reasoning · Requesty: Reasoning
Sie wollen wissen, welcher Thinking-Level sich für Ihren Anwendungsfall rechnet? Lassen Sie uns 30 Minuten über Ihren konkreten Workflow sprechen – unverbindlich, kostenlos, mit konkreten Vorschlägen am Ende. 30-Min-Gespräch buchen
Hinweis: Artikel mit KI-Unterstützung erstellt.