TLDR
Ein Cache-Treffer kostet bei Claude, OpenAI und Gemini 5–10 % des normalen Input-Preises. Anthropic cacht nur auf ausdrücklichen Wunsch, OpenAI, xAI und Gemini automatisch. Unter einer Mindestgröße von 512 bis 4 096 Tokens wird still nicht gecacht. Und fast überall bricht ein Wechsel des Thinking-Levels den Cache – außer bei den neuesten Claude-Modellen. Teil 1 der Serie „Was ein LLM-Aufruf wirklich kostet".
Einleitung
Jede Chat-Anwendung kennt das Muster: ein langer Systemprompt mit Regeln, Tool-Definitionen, vielleicht ein paar Seiten Kontext – und darunter eine kurze Frage. Ohne Caching wird der ganze Block bei jedem Aufruf neu verarbeitet und neu bezahlt. Bei einem 7 000-Token-Prompt und Claude Sonnet 5 sind das 1,45 Cent pro Aufruf, bevor das Modell ein einziges Wort geschrieben hat.
Prompt Caching hält den unveränderten Anfang des Prompts beim Anbieter vor. Das klingt nach einem Schalter. In der Praxis ist es eher eine Architekturfrage.
1. Wie Prefix-Caching funktioniert
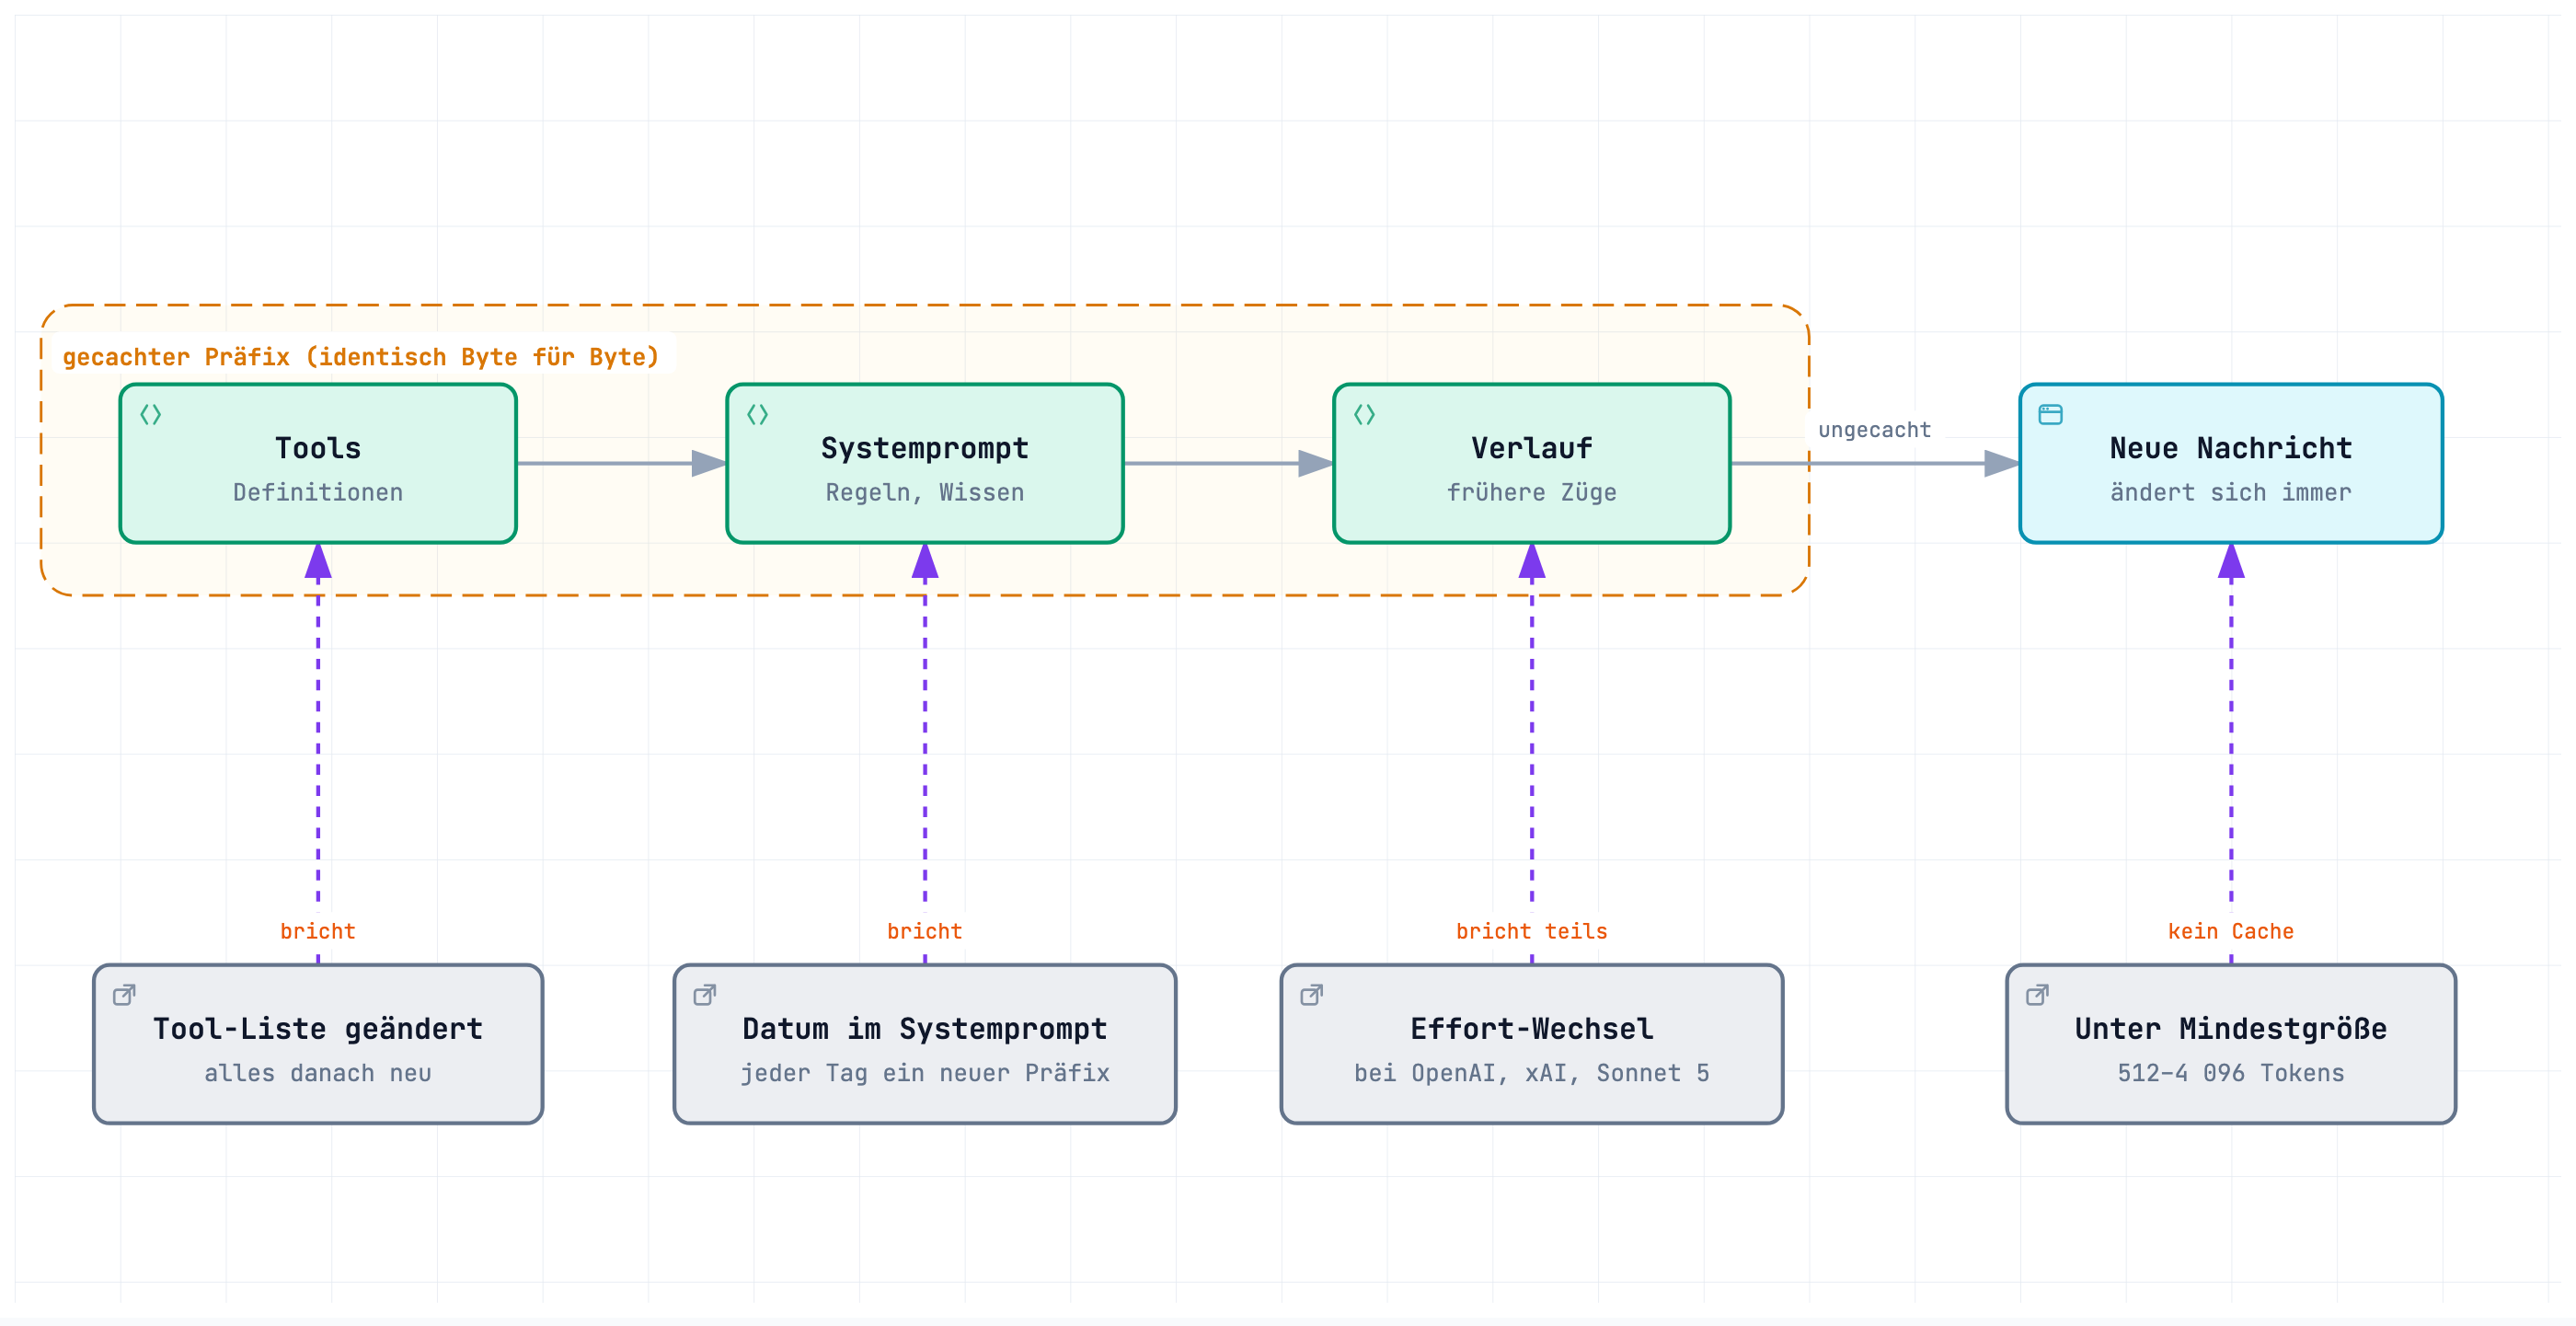
Gecacht wird immer ein Präfix: der Anfang des Prompts, Byte für Byte identisch mit einem früheren Aufruf. Die Reihenfolge ist dabei bei allen Anbietern ähnlich – Tools, Systemprompt, Gesprächsverlauf, zuletzt die neue Nachricht. Ändert sich ein Byte weit vorn, ist alles dahinter neu.
Daraus folgt die wichtigste Regel: Stabiles nach vorn, Veränderliches nach hinten.
2. Explizit oder automatisch
Wir haben denselben Prompt (je nach Tokenizer 4 568 bis 7 240 Tokens) zweimal direkt hintereinander gesendet und die Cache-Felder der zweiten Antwort ausgewertet:
| Anbieter / Modell | Steuerung | Treffer im 2. Aufruf | Cache-Write gemeldet |
|---|---|---|---|
| Claude Sonnet 5, Sonnet 5.5, Haiku 5.5 | cache_control (Block oder Top-Level) |
100 % | ja |
| GPT-6.1 Sol, GPT-5.6 Luna | automatisch | 100 % | ja |
| gpt-5-mini | automatisch | 98 % | nein |
| Grok 4.7, Grok 4.5 | automatisch | 99 % | nein |
| Gemini 3.8 Flash | implizit | 66 % | nein |
| Magistral Medium | prompt_cache_key |
99 % | nein |
| Mistral Medium | prompt_cache_key |
0 % | nein |
Anthropic cacht nur mit cache_control; ohne Marker trifft kein einziger Folgeaufruf. Der Top-Level-Marker („automatisches" Caching) und ein expliziter Block-Marker lieferten im direkten Vergleich dieselben Treffer.
Die beiden Varianten unterscheiden sich nur darin, wo der Marker steht (jeweils der zweite Aufruf, gekürzt aus unseren Rohdaten):
// Anthropic – Marker am Block
{
  "model": "claude-sonnet-5-5",
  "system": [{
    "type": "text",
    "text": "You are the assistant of …",
    "cache_control": { "type": "ephemeral" }   // ← cacht bis einschließlich dieses Blocks
  }],
  "messages": [ … ]
}
// Antwort
"usage": { "input_tokens": 16, "cache_read_input_tokens": 7224 }
// Anthropic – Marker auf oberster Ebene
{
  "model": "claude-sonnet-5-5",
  "system": [{ "type": "text", "text": "You are the assistant of …" }],
  "messages": [ … ],
  "cache_control": { "type": "ephemeral" }     // ← Anthropic setzt den Breakpoint selbst
}
// Antwort
"usage": { "input_tokens": 4, "cache_read_input_tokens": 7236 }
OpenAI cacht ohne jedes Zutun , meldet Treffer bei Chat Completions in prompt_tokens_details.cached_tokens und bei den neuen Modellen auch die Cache-Writes. Ob prompt_cache_key die Trefferquote erhöht, ließ sich in unserem Aufbau nicht zeigen – ohne Last trifft der Cache auch ohne Schlüssel (nicht messbar).
xAI cacht ebenfalls automatisch; der Schlüssel per Header x-grok-conv-id und prompt_cache_key im Body brachte in unserem Test keinen messbaren Unterschied. Eine Besonderheit: Grok 4.7 meldet schon beim allerersten Aufruf 1 152 gecachte Tokens – das ist ein eigener Systemprompt von xAI, den jede Anfrage mitbezahlt.
Bei Mistral cachte nur Magistral Medium mit prompt_cache_key, Mistral Medium gar nicht.
// Mistral – POST /v1/chat/completions
{
  "model": "magistral-medium-latest",
  "messages": [ … ],
  "prompt_cache_key": "88374757"     // ← frei wählbarer Schlüssel im Body, kein Header
}
// Antwort
"usage": {
  "prompt_tokens": 5807,
  "prompt_tokens_details": { "cached_tokens": 5760 }
}
3. Was ein Treffer kostet – und was ein Write
Ein Cache-Treffer ist günstig, das Schreiben in den Cache nicht unbedingt:
| Write | Read | lohnt sich ab | |
|---|---|---|---|
| Claude, 5 Minuten | 1,25× | 0,1× (Sonnet 5.5: 0,05×) | der 1. Wiederverwendung |
| Claude, 1 Stunde | 2× | 0,1× | der 2. Wiederverwendung |
| GPT-5.6 / 6.1 | 1,25× | 0,1× (Sol: 0,05×) | der 1. Wiederverwendung |
| gpt-5-mini und ältere | kostenlos | 0,1× | sofort |
| Gemini 3.8 Flash | – | 0,1× | sofort |
Die Faktoren stammen von den Preisseiten der Anbieter. Konkret für unseren Prompt mit Claude Sonnet 5: 1,45 Cent ungecacht, 1,81 Cent beim Schreiben, 0,15 Cent beim Lesen.
Tipp: Die 1-Stunden-TTL lohnt sich nur, wenn zwischen zwei Aufrufen regelmäßig mehr als fünf Minuten liegen und der Prompt danach noch mindestens zweimal gebraucht wird. Weil jeder Treffer die Stunde neu startet, hält ein regelmäßig genutzter Prompt praktisch beliebig lange.
4. Wie lange hält der Cache?
Nach dem ersten Aufruf haben wir 5,5 Minuten gewartet und dann wiederholt:
| Anbieter / Modell | nach 5,5 Minuten |
|---|---|
| Claude Sonnet 5.5, TTL 5 min | verfallen |
| Claude Sonnet 5.5, TTL 1 h | Treffer |
| GPT-6.1 Sol, GPT-5.6 Luna | Treffer |
| Grok 4.7 | Treffer |
| gpt-oss-120b über Cortecs | Treffer |
Der 5-Minuten-Cache von Anthropic hält, was er verspricht – und nicht länger. Der 1-Stunden-Cache hält über die fünf Minuten hinaus. Und jeder Treffer startet die Stunde neu: 61 Minuten nach dem Schreiben traf der Cache noch, weil der Treffer nach 5,5 Minuten ihn verlängert hatte. Der Cache von OpenAI überlebte die Pause dagegen ohne besondere Einstellung.
Die TTL ist bei Anthropic ein Feld im Marker. Mit welcher TTL geschrieben wurde, zeigt die Antwort getrennt an (erster Aufruf, gekürzt):
// Anthropic – POST /v1/messages
"cache_control": { "type": "ephemeral", "ttl": "1h" }   // ohne ttl: 5 Minuten
// Antwort
"usage": {
  "cache_creation_input_tokens": 7223,
  "cache_creation": {
    "ephemeral_5m_input_tokens": 0,
    "ephemeral_1h_input_tokens": 7223   // ← zum 2-fachen Input-Preis geschrieben
  }
}
5. Die Mindestgröße
Wir haben den Prompt knapp unter und knapp über die dokumentierte Mindestgröße gekürzt:
| Modell | Mindestgröße laut Doku | knapp darunter | knapp darüber |
|---|---|---|---|
| Claude Sonnet 5.5, Haiku 5.5 | 512 | 463 Tokens: kein Cache | 565 Tokens: 549 gecacht |
| Claude Sonnet 5 | 1 024 | 922: kein Cache | 1 124: 1 110 gecacht |
| GPT-6.1 Sol | 1 024 | 928: kein Cache | 1 131: 1 128 gecacht |
| Gemini 3.8 Flash | 4 096 | 3 684: kein Cache | 4 508: 2 474 gecacht |
Unter der Grenze passiert nichts – keine Fehlermeldung, kein Hinweis, nur ein Cache-Zähler, der auf 0 bleibt. Wer sich wundert, warum der Cache nie trifft, sollte zuerst hier nachsehen.
Auffällig: gpt-5-mini und Gemini cachen in Blöcken; ein Rest des Prompts bleibt immer ungecacht. Bei Gemini waren es bis zu 45 %.
6. Was den Cache bricht
Der heimtückischste Fall ist der Wechsel des Thinking-Levels. Wir haben denselben Prompt erst mit hohem, dann mit niedrigem und dann wieder mit hohem Effort gesendet:
| Anbieter / Modell | Effort geändert | zurück zum alten Effort |
|---|---|---|
| GPT-6.1 Sol, GPT-5.6 Luna, gpt-5-mini | Cache verloren | alter Cache trifft wieder |
| Grok 4.7 | Cache verloren | alter Cache trifft wieder |
| Gemini 3.8 Flash | Cache verloren | alter Cache trifft wieder |
| Claude Sonnet 5 | Cache verloren | alter Cache trifft wieder |
| Claude Sonnet 5.5, Haiku 5.5 | Cache bleibt | Cache bleibt |
Anthropic dokumentiert, dass ein geänderter Effort den Cache bricht. Für Sonnet 5 stimmt das, für die 5.5-Generation nicht mehr. Bei OpenAI, xAI, Gemini und den Open-Source-Modellen kostet jeder Wechsel den Cache. Der alte Eintrag bleibt aber erhalten: Wer zurückwechselt, trifft wieder.
Im Request ändert sich dabei ein einziges Feld. Was die Antwort daraus macht, hängt vom Modell ab (zweiter Aufruf, gekürzt):
// Anthropic – 2. Aufruf, nur der Effort ist anders
{
  "system": [{ …, "cache_control": { "type": "ephemeral" } }],
  "messages": [ … ],
  "output_config": { "effort": "low" }   // ← im 1. Aufruf "high"
}
// Antwort Claude Sonnet 5: Cache neu geschrieben
"usage": { "cache_creation_input_tokens": 7224, "cache_read_input_tokens": 0 }
// Antwort Claude Sonnet 5.5: Treffer
"usage": { "cache_creation_input_tokens": 0, "cache_read_input_tokens": 7222 }
Weitere Cache-Brecher laut Dokumentation: eine geänderte Tool-Liste (nicht gemessen). Und alles, was sich in den vorderen Teil des Prompts schleicht – Datum, Uhrzeit, Benutzername, eine Session-ID.
Lesson Learned: Ein Thinking-Level, das pro Anfrage „intelligent" gewählt wird, kann die Cache-Ersparnis vollständig auffressen. Legen Sie den Effort pro Gespräch fest, nicht pro Nachricht.
7. So haben wir es in .NET gelöst
In unserer Bibliothek Evanto.ChatClients setzt der Client für Anthropic zwei Marker: den Top-Level-Marker für den Gesprächsverlauf und einen eigenen Breakpoint am Systemprompt. Der zweite war nötig, weil der Top-Level-Marker allein über mehrere Gesprächszüge nicht traf:
var cacheControl = new AnthropicMessages.CacheControlEphemeral { Ttl = cacheTtl };
var marked       = messages.ToList();

if (options?.Instructions is { } instructions)
{
    marked.Insert(0, new ChatMessage(ChatRole.System,
    [
        new TextContent(instructions)
        {
            RawRepresentation = new AnthropicMessages.TextBlockParam { Text = instructions, CacheControl = cacheControl }
        }
    ]));
}
Quelle: MarkAnthropicSystemPrompt (Auszug)
Der stabile Systemprompt wandert dabei bewusst an den Anfang. Eine Systemnachricht mit dem aktuellen Datum, die CompanyWizard pro Gesprächszug einfügt, liegt so hinter dem Breakpoint und bricht den Cache nicht mehr.
Hinweis: Über Router bekommt Claude bei uns derzeit gar kein explizites Caching – und landet damit genau in der Lücke, die Teil 4 beschreibt.
8. Was bewusst offen blieb
- Last: Alle Messungen liefen ohne Parallellast. Ob
prompt_cache_keyoderx-grok-conv-idunter Last helfen, zeigt dieser Aufbau nicht. - Tool-Änderungen: haben wir nicht gemessen.
- Gemini 4 Argon: wegen eines Kontingentlimits nicht gemessen.
- Lange TTLs: Die 1-Stunden-TTL von Anthropic haben wir nach 5,5 und 61 Minuten geprüft. Wann sie ohne zwischenzeitlichen Treffer verfällt, haben wir nicht gemessen.
Fazit: übertragbare Patterns
- Prompt in Schichten bauen: Tools → stabiler Systemprompt → Verlauf → neue Nachricht. Datum und Benutzerdaten ans Ende.
- Mindestgröße prüfen: Bleibt der Cache-Zähler auf 0, ist der Präfix vermutlich zu kurz.
- Effort pro Gespräch festlegen, nicht pro Nachricht.
- Cache-Felder loggen: Read und Write pro Aufruf mitschreiben – nur so sieht man, ob der Cache arbeitet.
- TTL nach Nutzungsmuster wählen: 5 Minuten für Chats, 1 Stunde für seltene, aber wiederkehrende Batch-Läufe.
Alle Rohdaten und Skripte: github.com/evanto-media-ag/llm-caching-reasoning-costs
Die Serie
- Teil 1: Prompt Caching im Vergleich – was den Cache trägt und was ihn bricht
- Teil 2: Thinking-Level im Vergleich – sieben Werte, zwölf Interpretationen (erscheint demnächst)
- Teil 3: Kostentransparenz – Formeln, Feldnamen, Preisquellen (erscheint demnächst)
- Teil 4: Router im Vergleich – Cortecs, EU Router, Requesty, OpenRouter (erscheint demnächst)
Referenzen
- Anthropic: Prompt Caching
- OpenAI: Prompt Caching
- xAI: Prompt Caching
- Google: Gemini Caching
- Mistral: Prompt Caching
Ihr Systemprompt wird mit jedem Aufruf neu bezahlt? Lassen Sie uns 30 Minuten über Ihren konkreten Workflow sprechen – unverbindlich, kostenlos, mit konkreten Vorschlägen am Ende. 30-Min-Gespräch buchen
Hinweis: Artikel mit KI-Unterstützung erstellt.