TLDR
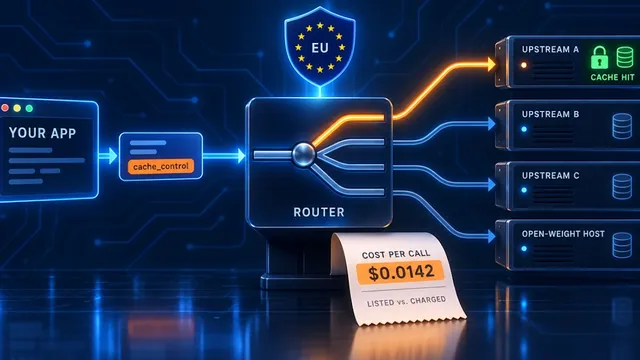
Kosten pro Aufruf liefern xAI, Requesty, EU Router und Cortecs direkt in der Antwort – und dort stimmte unsere Formel auf den Cent. OpenAI, Anthropic, Gemini und Mistral liefern nur Token-Zahlen; die Kosten muss man selbst rechnen. Dafür braucht man aktuelle Preise, die OpenAI, Mistral und Gemini nur auf Webseiten veröffentlichen. Und bei Routern gilt: Gelistet ist nicht berechnet. Teil 3 der Serie „Was ein LLM-Aufruf wirklich kostet".
Einleitung
Spätestens wenn die zweite Abteilung eine KI-Anwendung nutzt, kommt die Frage: Wer hat welchen Anteil an der Rechnung? Die Monatsrechnung des Anbieters hilft da wenig – sie kennt keine Kunden, keine Projekte, keine Abteilungen. Kostentransparenz entsteht nur, wenn man jeden Aufruf selbst bepreist oder der Anbieter die Kosten pro Aufruf mitliefert.
Beides ist schwieriger, als es aussieht. Dieser Teil zeigt, woran es hängt.
Reicht nicht die Abrechnung pro API-Key?
Naheliegender Einwand: Der Anbieter rechnet doch pro API-Key ab – warum jeden Aufruf selbst bepreisen? Der Key beantwortet genau eine Frage: welche Anwendung? Alle anderen Kostenfragen brauchen Kosten pro Aufruf.
- Kunde, Nutzer oder Feature. Ein SaaS-Produkt bedient viele Kunden über denselben Code. Einen Key pro Kunde anzulegen, zu verteilen und zu rotieren skaliert nicht. Ohne Kosten pro Kunde fehlen aber Marge und Ausreißer.
- Kosten pro Vorgang. Was kostet eine bearbeitete Rechnung, ein beantwortetes Ticket, ein Agentenlauf? Erst die Stückkosten zeigen den Nutzen; die Summe pro Key hat keinen Nenner.
- Budgets in Echtzeit. Ein Lauf soll stoppen, bevor das Budget erreicht ist, nicht am Monatsende. Dafür sind die Admin-APIs zu grob oder fehlen: OpenAI liefert Kosten nur tageweise. Anthropic verweigert einer Einzelorganisation den Zugriff (HTTP 403). Für die Gemini API gibt es nur Cloud Billing (nicht messbar). Mistral bietet eine Usage-API nur im Enterprise-Tarif (nicht messbar). EU Router hat nur das Dashboard (nicht gemessen).
- Mehrere Anbieter und Router. Die Kosten liegen in mehreren Dashboards und in verschiedenen Einheiten: Cortecs meldet Mikro-Euro, xAI Dollar-Ticks. Bei Routern bestimmt der tatsächlich gewählte Upstream den Preis (Abschnitt 7 und Teil 4); ein Key pro Router sagt darüber nichts.
- Interne Umlage oder Weiterberechnung. Wer Kosten auf Kostenstellen umlegt oder mit Aufschlag weiterberechnet, braucht belegbare Einzelposten.
- Optimierung belegen. Ob Prompt Caching oder ein niedrigerer Thinking-Level wirklich spart, zeigen nur Cache- und Reasoning-Tokens pro Aufruf (Teil 1 und Teil 2).
1. Die Formel
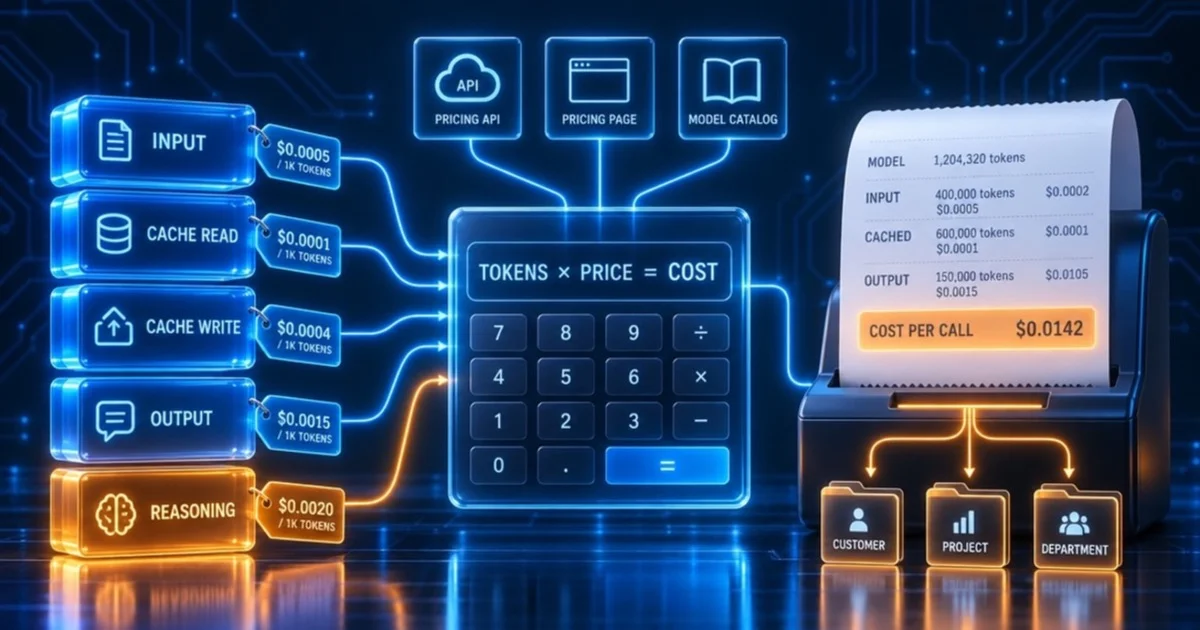
Die Kosten eines Aufrufs ergeben sich aus fünf Token-Arten und ihren Preisen:
Kosten = (Input − Cache-Read − Cache-Write) × Input-Preis
       + Cache-Read  × Read-Preis
       + Cache-Write × Write-Preis (5 min oder 1 h)
       + Output      × Output-Preis      (Reasoning steckt im Output)
Fehlt ein Cache-Preis, setzen wir den Input-Preis an – lieber etwas zu teuer geschätzt als Kosten verschwiegen. Wo der Anbieter selbst Kosten meldete, wich diese Formel um 0,0 % ab: bei xAI, Requesty, EU Router und für Claude über Cortecs.
2. Das Feldnamen-Chaos
Die Formel ist einfach. Das Einsammeln der Zahlen nicht – jeder Anbieter nennt dieselbe Größe anders:
| Anbieter | Input enthält Cache-Tokens? | Cache-Read | Cache-Write | Reasoning |
|---|---|---|---|---|
| Anthropic | nein | cache_read_input_tokens |
cache_creation_input_tokens (+ 5 min / 1 h) |
im Output |
| OpenAI Responses | ja | input_tokens_details.cached_tokens |
input_tokens_details.cache_write_tokens |
output_tokens_details.reasoning_tokens |
| OpenAI-kompatibel | ja | prompt_tokens_details.cached_tokens |
je Router verschieden | completion_tokens_details.reasoning_tokens |
| Gemini | ja | cachedContentTokenCount |
– | thoughtsTokenCount |
| Requesty | ja | cached_tokens |
caching_tokens (+ 5 min / 1 h) |
– |
Bei Anthropic enthält input_tokens die gecachten Tokens nicht; bei OpenAI-kompatiblen APIs sind sie in prompt_tokens enthalten. Die Feldnamen unterscheiden sich bei jedem Anbieter. Requesty meldet Cache-Writes als caching_tokens. Gemini meldet das Denken als thoughtsTokenCount.
Hinweis: Eine besonders tückische Falle: Bricht OpenAI eine Antwort wegen max_output_tokens ab, meldet die Usage für diesen Aufruf 0 Tokens – Input eingeschlossen. Die gute Nachricht aus der Admin-API (Abschnitt 4): Berechnet wurden diese Aufrufe auch nicht. Die schlechte: Eine Antwort gab es ebenfalls nicht – die Anwendung muss den Fall erkennen und wiederholen.
3. Kosten pro Aufruf: wer liefert sie?
| Anbieter / Router | Kosten in der Antwort | Format | Abweichung zu unserer Formel |
|---|---|---|---|
| xAI | ja | cost_in_usd_ticks (10¹⁰ = 1 USD) |
0,0 % |
| Requesty | ja | usage.cost in USD |
0,0 % |
| EU Router | ja | cost (USD) und cost_eur |
0,0 % (Claude) |
| Cortecs | ja | cost als Ganzzahl in Mikro-Euro |
0,0 % (Claude) |
| OpenRouter | ja | usage.cost in USD |
0,0 % (Claude) |
| OpenAI, Anthropic, Gemini, Mistral, IONOS | nein | nur Token-Zahlen | – |
xAI liefert die Kosten in Ticks; 10 Milliarden Ticks sind ein Dollar. Requesty und OpenRouter liefern USD, EU Router zusätzlich Euro zum EZB-Tageskurs. Cortecs liefert entgegen der eigenen API-Referenz ebenfalls Kosten in jeder Antwort – als Ganzzahl in Mikro-Euro, was nirgends dokumentiert ist. Ein Kosten-Header in der HTTP-Antwort existiert bei keinem Anbieter.
4. Kosten über Admin-APIs
Wer keine Kosten pro Aufruf bekommt, kann bei einigen Anbietern aggregierte Kosten abfragen – meist nur mit einem Admin-Schlüssel:
| Anbieter | Endpunkt | Auflösung | Status |
|---|---|---|---|
| OpenAI | /v1/organization/costs, /usage/completions |
Kosten täglich je Projekt, Usage minütlich je Schlüssel | stimmte exakt |
| xAI | management-api.x.ai/v1/billing/teams/{team}/usage |
bis sekundengenau | stimmte exakt |
| Anthropic | /v1/organizations/cost_report, /usage_report/messages |
Kosten täglich je Workspace | für Einzelorganisationen gesperrt |
| Cortecs | /v1/manage/logs, /manage/usage |
pro Anfrage, inkl. Fallbacks | nicht gemessen |
| Gemini | nur Cloud Billing | Stunden bis Tage Verzug | nicht messbar |
| Mistral | Admin-API nur im Enterprise-Tarif | täglich | nicht messbar |
Bei OpenAI meldete die Admin-API für unseren Schlüssel exakt dieselben Token-Zahlen wie unsere Rohdaten; die drei abgebrochenen Antworten mit 0 Usage zählte sie gar nicht als Anfrage – berechnet wurden sie also auch nicht. Die Tageskosten stimmten für alle drei Modelle auf den Cent mit unserer Formel überein und waren schon am selben Tag abrufbar. Kosten gibt es nur tageweise, und der Usage-API fehlt ein Reasoning-Feld. Nebenbei zeigt die Abrechnung eine eigene Position für 12-Stunden-Cache-Writes. Die Management-API von xAI meldete exakt die Summe der Kostenfelder aller Einzelantworten. Anthropic liefert Kosten laut Doku tageweise je Workspace (nicht gemessen) – für unsere Einzelorganisation verweigerte die API selbst mit organisationsweitem Schlüssel den Zugriff (HTTP 403). Für die Gemini API gibt es nur Cloud Billing (nicht messbar). Mistral bietet eine Usage-API nur im Enterprise-Tarif (nicht messbar). EU Router hat keine API für den Kostenverlauf, nur das Dashboard (nicht gemessen).
Tipp: Für einen sauberen Abgleich mit Admin-APIs braucht jede Anwendung einen eigenen Schlüssel in einem eigenen Projekt oder Workspace. Sonst landen Kosten mehrerer Anwendungen im selben Topf.
5. Woher die Preise kommen
Eigene Kostenrechnung braucht aktuelle Preise. Maschinenlesbar liefern sie nur einige:
- Per API: xAI , Cortecs (in EUR) , EU Router, Requesty und OpenRouter.
- Nur Webseite: OpenAI, Mistral und Gemini. Anthropic liefert über
/v1/modelsFähigkeiten und Effort-Stufen, aber keine Preise.
Dazu kommen öffentliche Sammlungen. models.dev führt keinen Preis für den 1-Stunden-Cache-Write , LiteLLM schon. Die Cache-Faktoren in der OpenRouter-Dokumentation weichen von den Preisseiten der Anbieter ab.
Und Preise haben Stufen: xAI verdoppelt alle Preise ab 200 000 Tokens Kontext , GPT-6.1 Sol ab 272 000 Tokens Input. Ein Preis pro Modell reicht also nicht – es braucht einen Preis pro Modell und Kontextgröße.
6. Unser Katalog im Abgleich
Für CompanyWizard betreiben wir einen eigenen Modellkatalog. Er führt models.dev (welche Modelle es gibt) mit LiteLLM (genauere Cache-Preise, auch für 1 Stunde) zusammen und prüft die Preise gegen OpenRouter; Abweichungen über 25 % landen im Log. Router-Preise stehen als eigene Einträge je Hoster daneben, bei Cortecs in Euro.
Wir haben den Katalog gegen die Messungen gehalten:
- Preise: Bei allen gemessenen Modellen, die der Katalog führt, stimmten die Preise mit den Preisseiten überein.
- Effort-Stufen: Auch die Stufen stimmten – für Claude, Gemini und GPT-5.6 Luna genau die Werte, die die API annahm.
- Lücken: Drei der gemessenen Modelle fehlten: Claude Sonnet 5 bei Anthropic direkt, GPT-6.1 Sol und gpt-5-mini bei OpenAI.
Die Lücken entstehen durch den Freigabeschritt: Neue Modelle kommen als Vorschlag in den Katalog und erst nach manueller Prüfung zu den Anwendungen. Das ist gewollt – ein falscher Preis ist schlimmer als ein fehlender –, kostet aber Aktualität.
7. Gelistet ist nicht berechnet
Bei Routern kommt eine weitere Unsicherheit hinzu: Der gelistete Preis ist oft der Preis des günstigsten Upstreams, berechnet wird der tatsächlich gewählte.
| Router | Modell | Abweichung vom gelisteten Preis (Median) |
|---|---|---|
| EU Router | gpt-oss-120b | +103 % |
| Cortecs | gpt-oss-120b | +50 % bis +67 % |
| Cortecs | DeepSeek V4.1 Flash | +44 % |
| Cortecs, EU Router, Requesty | Claude Sonnet 5 | 0 % |
Bei Open-Source-Modellen lagen die berechneten Kosten bis zu 170 % über dem Listenpreis. Bei Claude stimmten sie, dafür listet EU Router Claude Sonnet 5 10 % teurer als die anderen.
8. So haben wir es in .NET gelöst
Microsoft.Extensions.AI kennt eine Eigenschaft für Cache-Reads, aber keine für Cache-Writes. Der Anthropic-Adapter legt sie deshalb in ein Zusatzfeld – und nur, wenn der Wert größer als 0 ist:
public const String CacheCreationInputTokensKey = "CacheCreationInputTokens";

public TurnTokenUsage Add(UsageDetails? usage)
{
    var cacheWrite = usage.AdditionalCounts?.TryGetValue(CacheCreationInputTokensKey, out var written) == true ? written : 0L;

    return new TurnTokenUsage(
        Input      + (Int32) (usage.InputTokenCount       ?? 0),
        Output     + (Int32) (usage.OutputTokenCount      ?? 0),
        CacheRead  + (Int32) (usage.CachedInputTokenCount ?? 0),
        CacheWrite + (Int32) cacheWrite);
}
Quelle: TurnTokenUsage (Auszug)
In CompanyWizard zählt TurnTokenUsage an jeder Stelle mit, an der ein Gesprächszug ein Modell aufruft, auch in Tool-Schleifen und nach Unterbrechungen. Ein einziger Buchungsweg schreibt daraus einen Datensatz pro Zug.
Lesson Learned: Ein Stream, der mittendrin abbricht, bucht bei uns nichts – das Anthropic-SDK meldet die Usage erst am Ende des Streams. Diese Lücke ist bekannt und dokumentiert. Geschlossen ist sie nicht.
9. Was bewusst offen blieb
- Admin-APIs: Anthropic (Einzelorganisation, HTTP 403) und Cortecs (kein Management-Schlüssel) haben wir nicht abgeglichen.
- Batch-, Flex- und Priority-Tarife: nicht Teil dieser Serie.
- Bildpreise: ebenfalls nicht.
Fazit: übertragbare Patterns
- Usage pro Anbieter normalisieren, bevor gerechnet wird – vor allem die Frage, ob Input die Cache-Tokens enthält.
- Kostenfelder nutzen, wo es sie gibt, und die eigene Formel daran prüfen.
- Preise mit Stand und Kontextstufe speichern, nicht als eine Zahl pro Modell.
- Den Key für die Anwendung, die Kosten pro Aufruf für alles darunter: Ein eigener Schlüssel pro Anwendung hält Admin-APIs zuordenbar; Kunde, Vorgang und Budget brauchen die Kosten pro Aufruf.
- Bei Routern den Upstream pinnen, wenn der Preis planbar sein muss.
Alle Rohdaten und Skripte: github.com/evanto-media-ag/llm-caching-reasoning-costs
Die Serie
- Teil 1: Prompt Caching im Vergleich – was den Cache trägt und was ihn bricht
- Teil 2: Thinking-Level im Vergleich – sieben Werte, zwölf Interpretationen
- Teil 3: Kostentransparenz – Formeln, Feldnamen, Preisquellen
- Teil 4: Router im Vergleich – Cortecs, EU Router, Requesty, OpenRouter
Referenzen
- OpenAI: Usage API Cookbook
- Anthropic: Usage and Cost API
- xAI: Cost Tracking
- Cortecs: Management API · Requesty: Cost Tracking · EU Router: Generation API
- models.dev · LiteLLM Preistabelle
Sie wollen KI-Kosten pro Kunde oder Abteilung ausweisen? Lassen Sie uns 30 Minuten über Ihren konkreten Workflow sprechen – unverbindlich, kostenlos, mit konkreten Vorschlägen am Ende. 30-Min-Gespräch buchen
Hinweis: Artikel mit KI-Unterstützung erstellt.