TLDR
Ein LLM-Aufruf besteht nicht aus zwei, sondern aus fünf Token-Arten mit eigenen Preisen. Wer Prompt Caching richtig nutzt, zahlt für einen wiederholten Prompt rund 90 % weniger. Wer es falsch nutzt, zahlt beim ersten Aufruf 25 % mehr und spart danach nichts. Router entscheiden mit, ob überhaupt gecacht wird, und berechnen bei Open-Source-Modellen teils deutlich mehr als gelistet. Alle Zahlen in dieser Serie sind gemessen; Skripte und Rohdaten liegen öffentlich auf GitHub.
Einleitung
Preis pro Million Input-Tokens, Preis pro Million Output-Tokens, fertig – so sieht jede Preistabelle aus. Die Rechnung am Monatsende stellt sich trotzdem anders dar. Schuld sind drei Stellschrauben, die in keiner Preistabelle stehen: Prompt Caching, Thinking-Level (Reasoning Effort) und die Wahl des Anbieters oder Routers.
Dieser Artikel ist der Auftakt einer Serie. Er fasst zusammen, was wir am 19. Oktober 2026 bei OpenAI, Anthropic, xAI, Google Gemini, Mistral, IONOS und den Routern Cortecs, EU Router, Requesty und OpenRouter gemessen haben. Die vier Vertiefungen folgen in den nächsten Wochen.
Wir vergleichen hier keine Feature-Listen. Wir haben alles nachgemessen, mit denselben Prompts und derselben Auswertung, und jede Aussage hat einen Beleg.
1. Ein Aufruf, fünf Preise
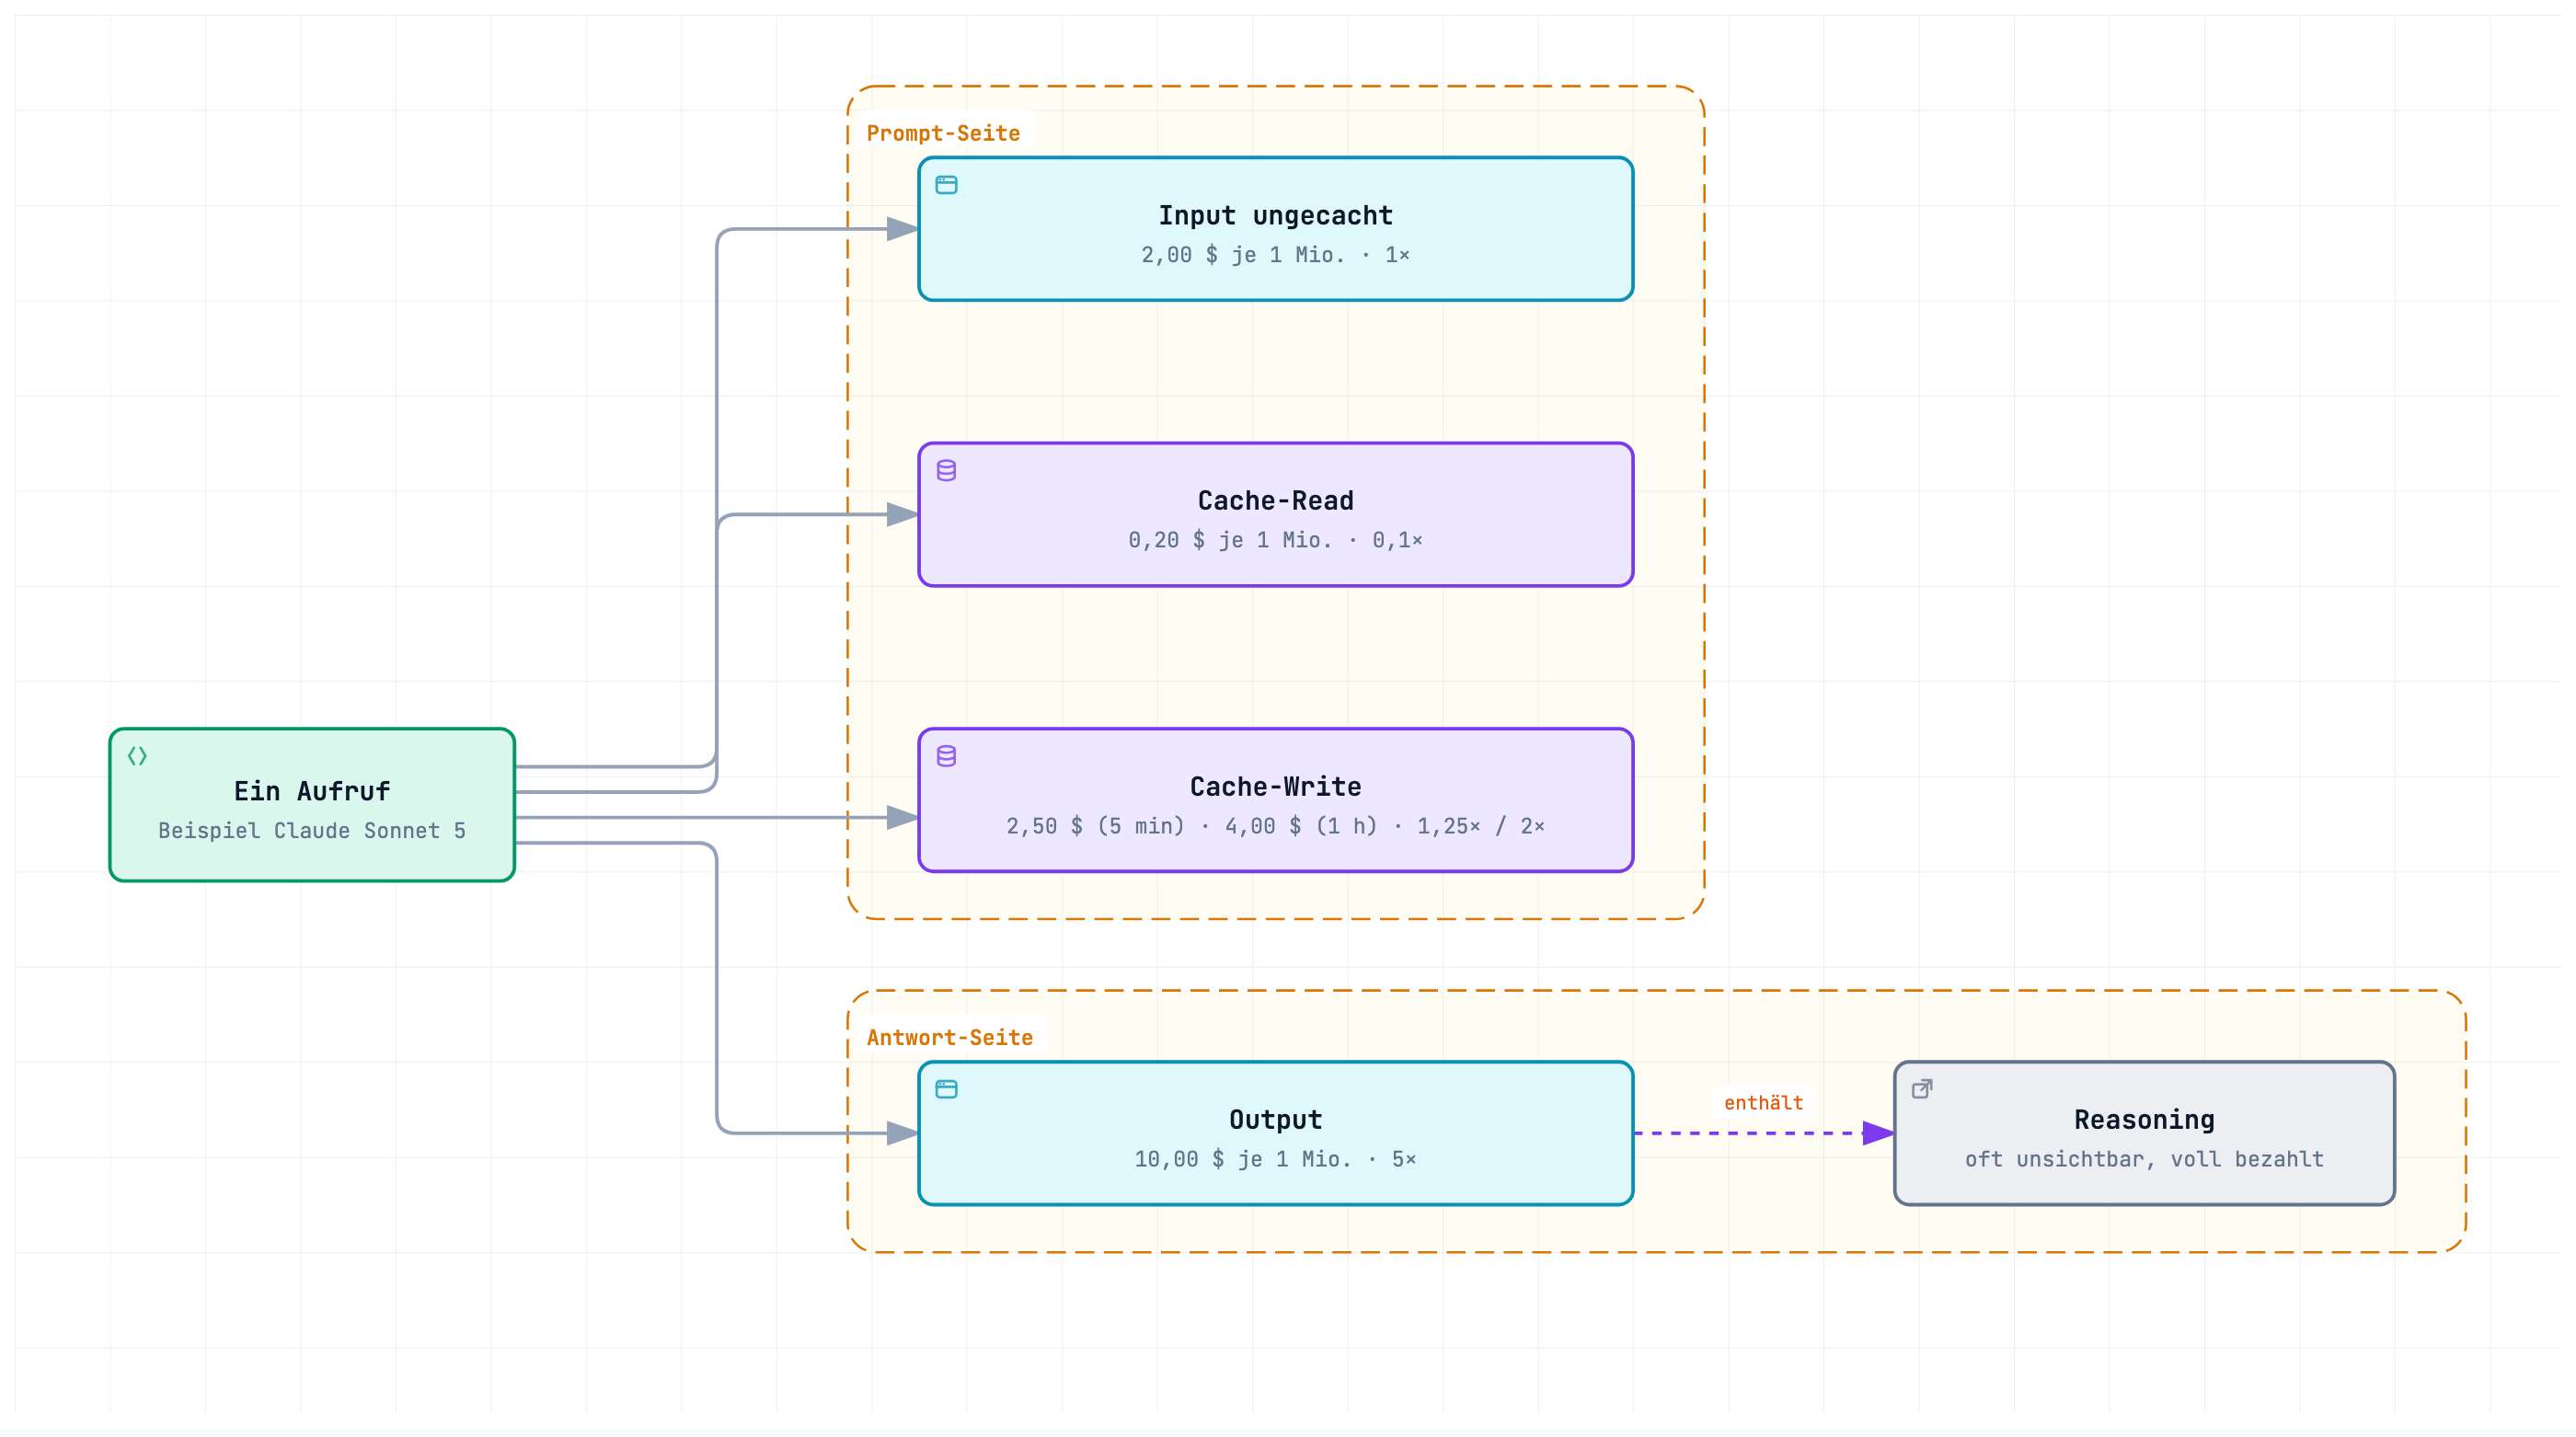
Ein einzelner Aufruf zerfällt preislich in fünf Token-Arten:
| Token-Art | Was es ist | Claude Sonnet 5 | GPT-6.1 Sol | Grok 4.7 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| Input (ungecacht) | Prompt-Teil, der neu verarbeitet wird | 2,00 $ | 2,00 $ | 2,00 $ | 0,75 $ |
| Cache-Read | Prompt-Teil aus dem Cache | 0,20 $ (0,1×) | 0,10 $ (0,05×) | 0,50 $ (0,25×) | 0,075 $ (0,1×) |
| Cache-Write | Prompt-Teil, der in den Cache geschrieben wird | 2,50 $ / 4,00 $ (5 min / 1 h) | 2,50 $ (1,25×) | – | – |
| Output | Antwort | 10,00 $ | 10,00 $ | 6,00 $ | 3,75 $ |
| Reasoning | „Denken" vor der Antwort | wie Output | wie Output | wie Output | wie Output |
Preise je 1 Mio. Tokens, Stand 19.10.2026, laut Preisseiten bzw. Preis-API der Anbieter.
Anthropic berechnet einen Cache-Write mit dem 1,25-fachen Input-Preis für 5 Minuten und dem 2-fachen für 1 Stunde. Der Faktor für Cache-Reads ist selbst innerhalb eines Anbieters nicht einheitlich: Claude Sonnet 5.5 liest für 0,05×, Claude Sonnet 5 für 0,1×. Bei OpenAI liegt der Read-Faktor für GPT-6.1 Sol bei 0,05× statt der oft zitierten 0,1×. xAI liefert seine Preise sogar per API aus, inklusive Cache-Preis.
Hinweis: Ein Token ist nicht überall gleich groß. Derselbe Systemprompt zählte bei Claude 7 229 Tokens, bei OpenAI 4 568. Das sind 58 % Unterschied. Ein Preisvergleich pro Million Tokens vergleicht also Äpfel mit etwas kleineren Äpfeln.
Zur Rechnung selbst: Jede Antwort enthält einen Usage-Block, in dem der Anbieter die verbrauchten Tokens auflistet. Bei Anthropic enthält input_tokens die gecachten Tokens nicht, bei OpenAI-kompatiblen APIs enthält prompt_tokens sie sehr wohl. Die Feldnamen für dieselbe Größe unterscheiden sich ohnehin bei jedem Anbieter. Wer Kosten selbst nachrechnet, muss das pro Anbieter normalisieren. Sonst zählt er Cache-Tokens doppelt oder gar nicht.
2. Die drei Hebel
2.1 Prompt Caching
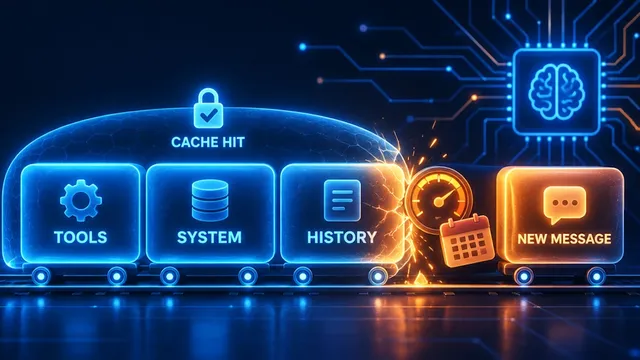
Wiederholt sich der Anfang eines Prompts (der Präfix), etwa Systemprompt, Tool-Definitionen oder Dokumente, kann der Anbieter ihn aus einem Cache lesen. Bei Claude Sonnet 5 kostete unser 7 200-Token-Prompt ungecacht 1,45 Cent, mit Cache-Write 1,81 Cent und aus dem Cache 0,15 Cent. Der erste Aufruf ist also teurer, ab dem zweiten spart man rund 90 %.
Die Mechanik unterscheidet sich je Anbieter:
- Anthropic cacht nur, wenn man es mit
cache_controlverlangt, einem Marker im Request; ohne Marker lag die Trefferquote bei 0 von 4 Folgeaufrufen. - OpenAI, xAI und Gemini cachen automatisch. OpenAI ab 1 024 Tokens , Gemini 3.8 Flash ab 4 096 , und Gemini cacht dabei nur einen Teil des Prompts.
- Unter der Mindestgröße passiert schlicht nichts: kein Cache, keine Fehlermeldung.
So sieht das im Request aus: Bei Anthropic ist cache_control kein Header, sondern ein Feld im jeweiligen Inhaltsblock. OpenAI braucht gar nichts. Den Treffer melden beide in der Antwort, nur unter verschiedenen Namen (jeweils der zweite Aufruf, gekürzt aus unseren Rohdaten):
// Anthropic – POST /v1/messages
{
  "model": "claude-sonnet-5-5",
  "system": [{
    "type": "text",
    "text": "You are the assistant of …",
    "cache_control": { "type": "ephemeral" }   // ← Cache-Marker am Block
  }],
  "messages": [ … ]
}
// Antwort
"usage": {
  "input_tokens": 16,                // nur der ungecachte Rest
  "cache_creation_input_tokens": 0,
  "cache_read_input_tokens": 7224,   // ← aus dem Cache
  "output_tokens": 4
}
// OpenAI – POST /v1/responses
{
  "model": "gpt-6.1-sol",
  "instructions": "You are the assistant of …",   // kein Marker nötig
  "input": "Reply with the single word OK."
}
// Antwort
"usage": {
  "input_tokens": 4576,              // enthält die gecachten Tokens
  "input_tokens_details": {
    "cached_tokens": 4573            // ← aus dem Cache
  },
  "output_tokens": 5
}
Teil 1 der Serie zeigt, was den Cache bricht, unter anderem ein Wechsel des Thinking-Levels, der bei manchen Modellen den Cache kostet und bei anderen nicht.
2.2 Thinking-Level
Fast jedes aktuelle Modell kann vor der Antwort „nachdenken", und fast jeder Anbieter nennt den Regler anders: reasoning.effort, output_config.effort, thinkingLevel, reasoning_effort. Wir haben jeden der sieben üblichen Werte von none bis max an jedes Modell geschickt. Das Ergebnis ist ein Flickenteppich:
- GPT-6.1 Sol lehnt
noneundminimalab. - Claude lehnt
noneundminimalab, akzeptiert abermax; das altebudget_tokensbeantwortet die API mit HTTP 400. - Mistral akzeptierte nur
noneundhigh. - xAI lässt sich nicht abschalten:
nonewird abgelehnt.
Teuer ist das Denken in jedem Fall: Reasoning-Tokens werden als Output berechnet, auch wenn die Antwort sie nicht zeigt. Claude Haiku 5.5 berechnete 53 Thinking-Tokens für eine Antwort von acht Zeichen, ohne einen einzigen davon anzuzeigen.
Im Request sitzt der Regler bei jedem Anbieter an einer anderen Stelle, und in der Antwort heißen die Denk-Tokens jedes Mal anders (dieselbe Rechenaufgabe mit high, gekürzt):
// OpenAI – POST /v1/responses
{
  "model": "gpt-6.1-sol",
  "input": "A bat and a ball cost 1.10 EUR …",
  "reasoning": { "effort": "high" }          // ← Objekt reasoning, Feld effort
}
// Antwort
"usage": {
  "output_tokens": 24,
  "output_tokens_details": { "reasoning_tokens": 14 }   // in output_tokens enthalten
}
// Anthropic – POST /v1/messages
{
  "model": "claude-haiku-5-5",
  "messages": [ … ],
  "output_config": { "effort": "high" }      // ← Objekt output_config
}
// Antwort
"usage": {
  "output_tokens": 62,
  "output_tokens_details": { "thinking_tokens": 53 }    // in output_tokens enthalten
}
// Gemini – POST /v1beta/models/gemini-3.8-flash:generateContent
{
  "contents": [ … ],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "high" }   // ← zwei Ebenen tief
  }
}
// Antwort: usageMetadata statt usage
"usageMetadata": {
  "candidatesTokenCount": 5,
  "thoughtsTokenCount": 247          // zusätzlich zu den 5 Antwort-Tokens
}
Router nehmen auch Werte an, die der Anbieter selbst ablehnt. Cortecs akzeptierte none für Claude, Anthropic direkt nicht. Ein Router, der jeden Wert annimmt, ist höflich. Ob er ihn auch befolgt, ist eine andere Frage. Teil 2 geht ihr nach.
2.3 Router und Hoster
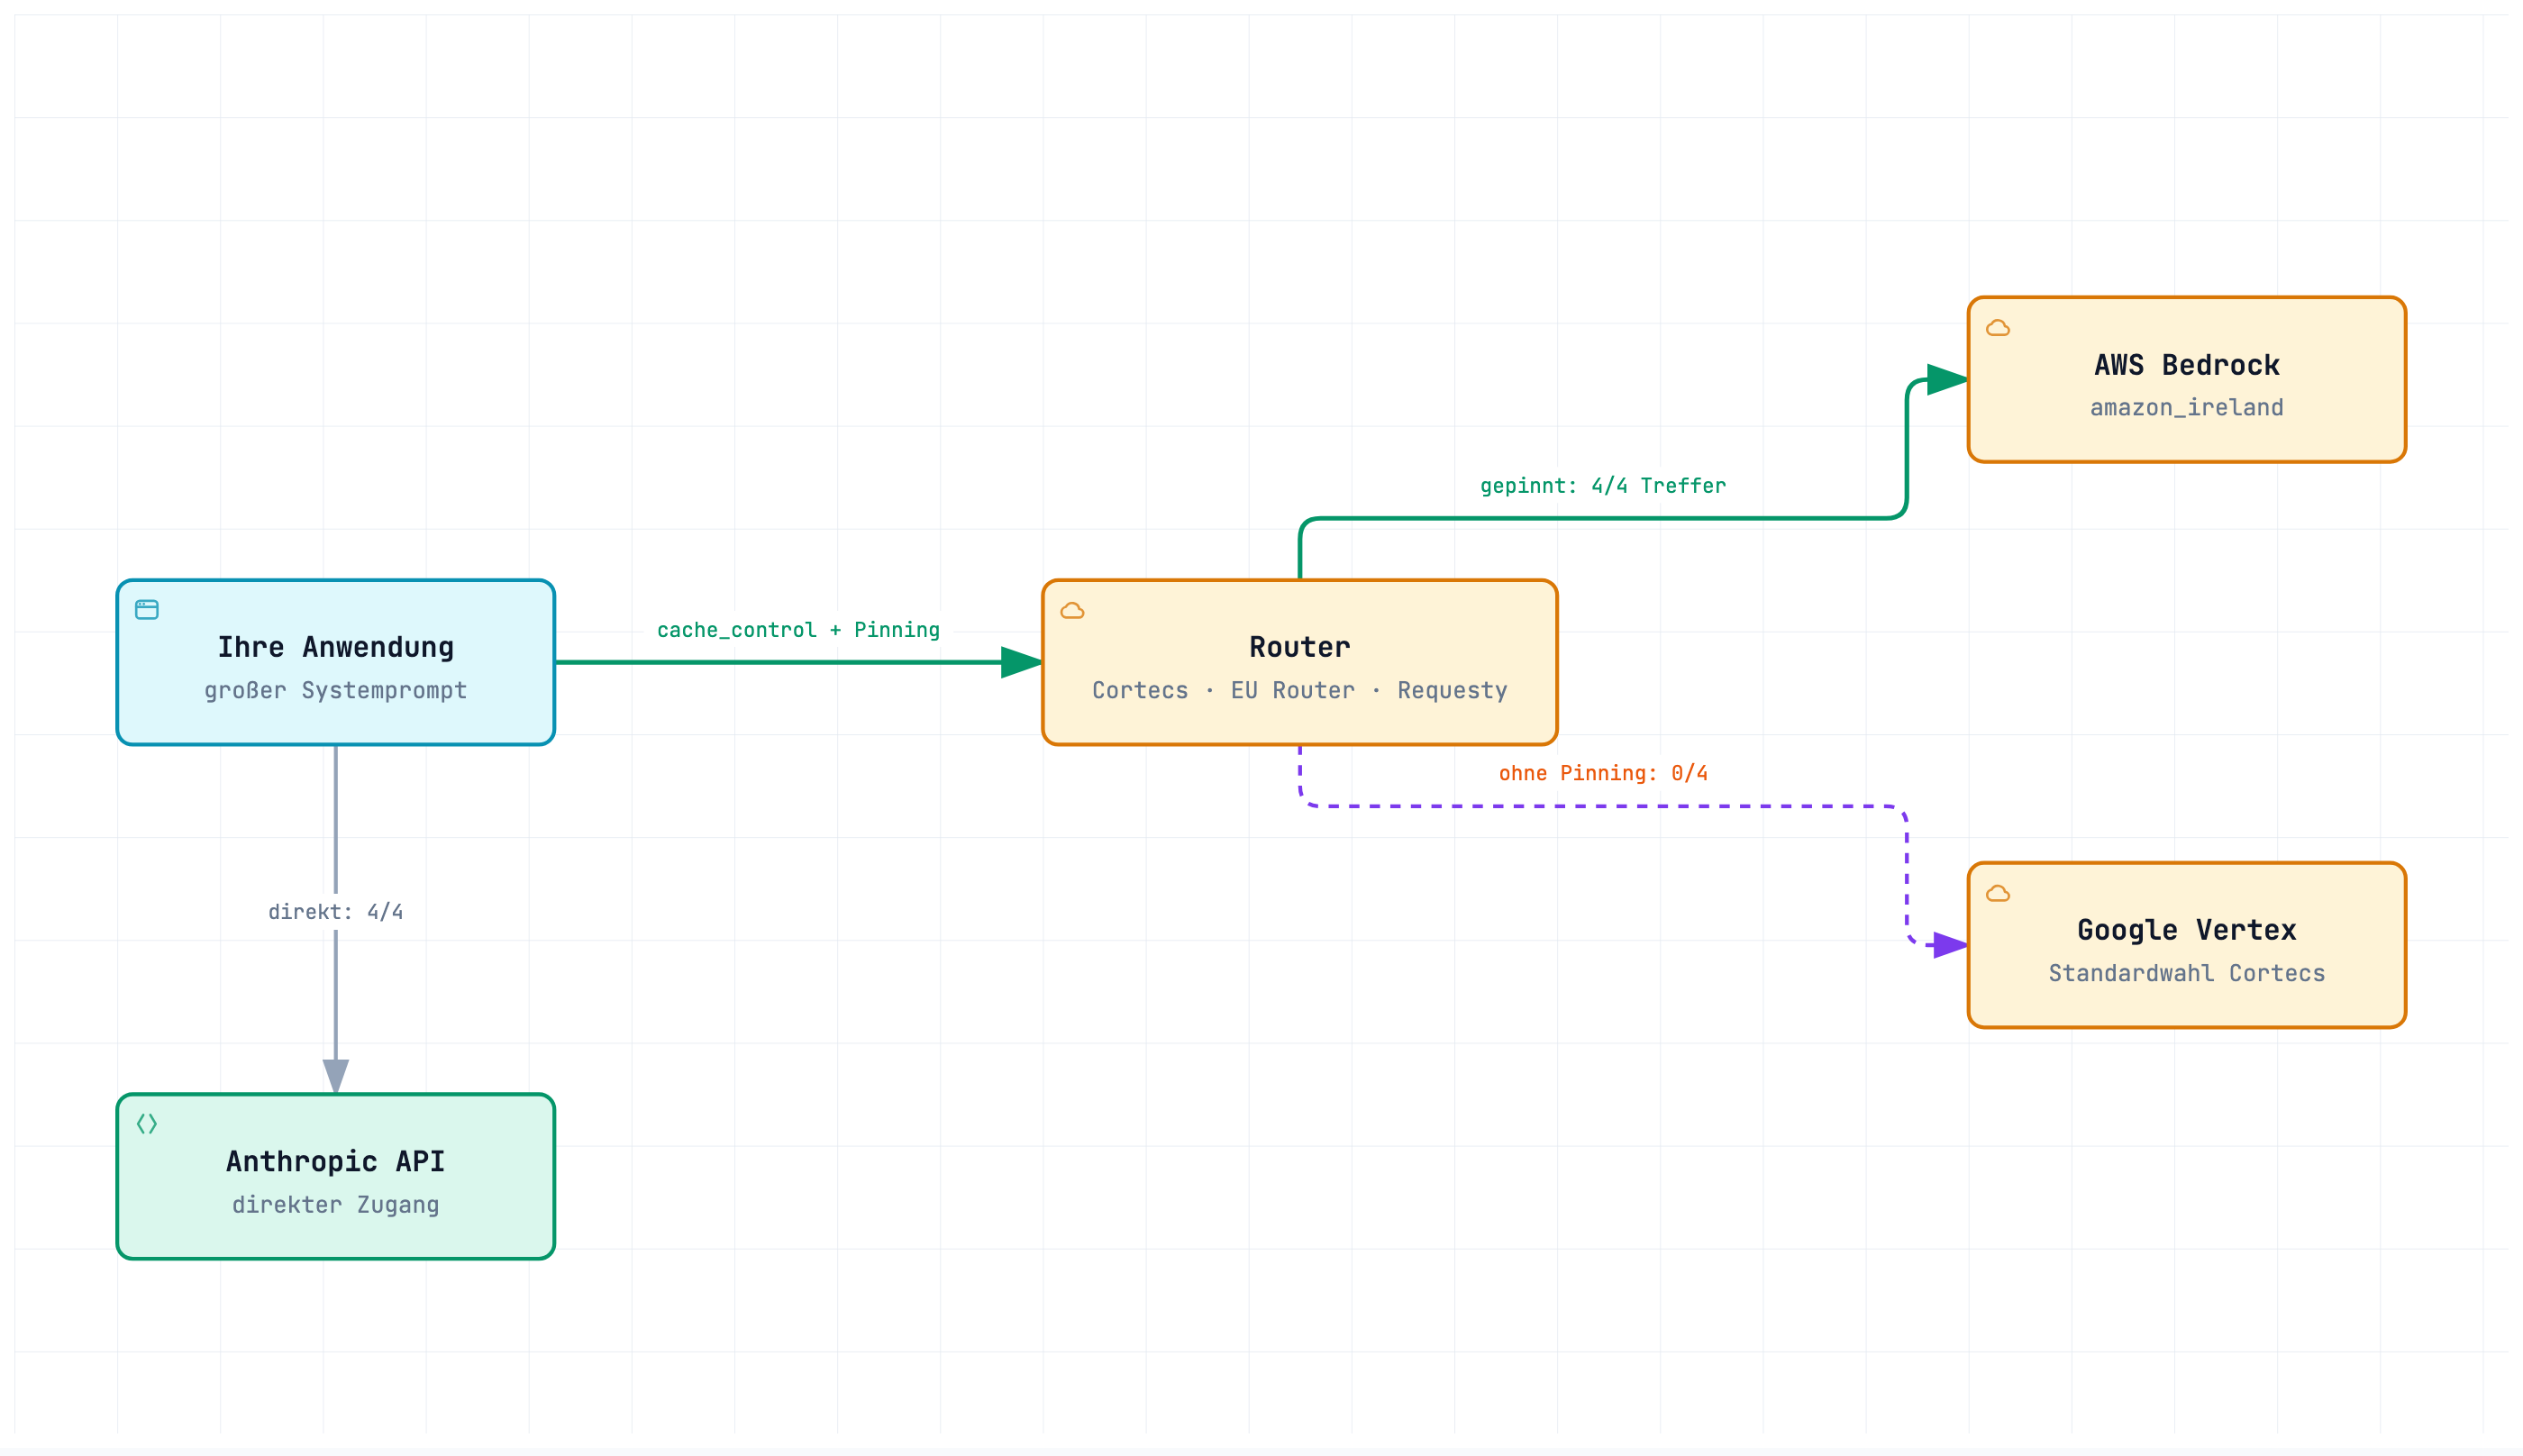
Router wie Cortecs, EU Router oder Requesty bündeln viele Modelle hinter einer API und versprechen Auswahl, Ausfallsicherheit und – bei den europäischen Anbietern – Datenverarbeitung in der EU. Den Anbieter, an den ein Router den Aufruf tatsächlich weitergibt, nennt man Upstream. Legt man ihn im Request fest, statt den Router wählen zu lassen, heißt das Pinning. Hoster wie IONOS betreiben die Modelle dagegen selbst. Für die Kosten heißt das:
- Ohne
cache_controlcacht Claude über keinen der Router, mit Marker bei allen. EU Router reicht den Marker durch, obwohl die Doku ihn nicht erwähnt. - Der Router wählt den Upstream. Cortecs schickte Claude ohne Vorgabe zu Google Vertex – 0 von 4 Cache-Treffern. Auf AWS Bedrock gepinnt: 4 von 4.
- Gelistet ist nicht berechnet. Bei Open-Source-Modellen (genauer: Open-Weight, also Modelle mit frei verfügbaren Gewichten) lag der tatsächlich berechnete Preis bei Cortecs und EU Router bis zu 170 % über dem gelisteten, weil der Router einen teureren Upstream wählte. Das hat uns am meisten überrascht: Bei Open-Source-Modellen über Router ist der Listenpreis eher eine Untergrenze.
- Aufschläge gibt es auch. EU Router listet Claude Sonnet 5 10 % teurer als Anthropic, OpenRouter und Requesty.
Bei Open-Source-Modellen ist der Hoster ohnehin der entscheidende Faktor: Dasselbe gpt-oss-120b cachte bei Cortecs und Requesty, bei IONOS nicht.
3. Kostentransparenz: wer liefert was?
Für ein Controlling pro Anwendung, Kunde oder Abteilung braucht man Kosten pro Aufruf. Die liefern längst nicht alle:
- Pro Aufruf in der Antwort: xAI in
cost_in_usd_ticks, Requesty inusage.cost, EU Router in Euro und Cortecs als Ganzzahl in Mikro-Euro, entgegen der eigenen API-Referenz. - Nur aggregiert über Admin-APIs, also Verwaltungsschnittstellen mit eigenem Schlüssel: OpenAI liefert Kosten nur tageweise. Anthropic sperrt diese API für Einzelorganisationen.
- Gar nicht per API: Für die Gemini API gibt es nur Cloud Billing (nicht messbar).
Wo Kosten in der Antwort stehen, dann im Usage-Block, aber jedes Mal in einer anderen Einheit (gekürzt aus unseren Rohdaten):
// xAI – POST /v1/responses (grok-4.7)
"usage": {
  "input_tokens": 5809,
  "input_tokens_details": { "cached_tokens": 5760 },
  "output_tokens": 65,
  "cost_in_usd_ticks": 33680000      // ← 10 Mrd. Ticks = 1 $, also 0,003368 $
}
// Cortecs – POST /v1/chat/completions (gpt-oss-120b)
"usage": {
  "prompt_tokens": 4636,
  "completion_tokens": 16,
  "cost": 631,                       // ← Ganzzahl in Mikro-Euro, also 0,000631 €
  "cost_details": { "prompt_cost": 613, "cache_read_cost": 9, "completion_cost": 9 }
}
// EU Router – POST /api/v1/chat/completions (claude-sonnet-5)
"usage": {
  "prompt_tokens": 7239,
  "completion_tokens": 4,
  "cost": 0.0159698,
  "cost_currency": "USD",
  "cost_eur": 0.01419156277          // ← derselbe Betrag in Euro
}
Wo der Anbieter Kosten liefert, stimmte unsere Formel auf den Cent: 0,0 % Abweichung bei xAI, Requesty, EU Router und den Tageswerten von OpenAI.
Tipp: Preise per API liefern xAI, Cortecs, EU Router, Requesty und OpenRouter; OpenAI, Mistral und Gemini veröffentlichen sie nur auf Webseiten. Genau diese Lücke schließt ein Preiskatalog, wie wir ihn für CompanyWizard betreiben. Teil 3 zeigt, wie man so etwas aus models.dev, LiteLLM und den Router-APIs zusammensetzt.
4. Die Vergleichsmatrix
Stand: 19. Oktober 2026. Jede Zelle ist gemessen; Details und Rohdaten im Repository.
| Anbieter | Caching (Treffer im 2. Aufruf) | Cache-Steuerung | Cache-Write in der Usage | Effort-Werte angenommen (von 7) | Kosten pro Aufruf | Preise per API |
|---|---|---|---|---|---|---|
| Anthropic | 100 % | explizit (cache_control) |
ja | 5 | nein | nein |
| OpenAI | 100 % | automatisch | ja (GPT-5.6+) | 4–6 | nein | nein |
| xAI | 99 % | automatisch | nein | 5 | ja (USD) | ja |
| Google Gemini 3.8 Flash | 66 % | automatisch | nein | 3 | nein | nein |
| Mistral | teils (nur Magistral) | prompt_cache_key |
nein | 2 | nein | nein |
| IONOS (Open Source) | 0 % | – | nein | 3–4 | nein | nein |
| Cortecs | je Upstream | automatisch / gepinnt | ja | 7 | ja (µEUR) | ja (EUR) |
| EU Router | mit cache_control |
durchgereicht | ja | 5–7 | ja (EUR) | ja |
| Requesty | mit cache_control oder auto_cache |
durchgereicht / automatisch | ja | 6 | ja (USD) | ja |
| OpenRouter | mit cache_control |
durchgereicht, Sticky Routing | ja | 6–7 | ja (USD) | ja |
OpenRouter reicht cache_control inklusive 1-Stunden-TTL (der Lebensdauer des Cache-Eintrags) durch und hält Folgeaufrufe mit Session-Schlüssel, einer frei wählbaren Kennung pro Gespräch, beim selben Upstream. Das nennt sich Sticky Routing.
5. Welcher Anbieter für welchen Zweck
| Wenn Ihnen wichtig ist … | … dann | Warum |
|---|---|---|
| maximale Ersparnis bei langen, wiederholten Prompts | Anthropic oder OpenAI direkt, Cache bewusst setzen | 90–95 % Rabatt auf Cache-Reads, Writes sichtbar in der Usage |
| Caching ohne Code-Änderung | OpenAI, xAI | cachen automatisch, ohne Marker im Request |
| Kosten pro Aufruf fürs Controlling | xAI, Requesty, EU Router, Cortecs | Kostenfeld in jeder Antwort |
| Verarbeitung in der EU mit Claude | Router mit gepinntem EU-Upstream und cache_control |
sonst entscheidet der Router über Upstream und Cache |
| Open-Source-Modelle zum Listenpreis | Hoster direkt oder Router mit festem Upstream | Router mit freier Upstream-Wahl berechneten bis zu 170 % mehr |
| feine Steuerung des Thinking-Levels | OpenAI, Anthropic direkt | Router nehmen Werte an, die sie nicht weitergeben können |
6. So haben wir es in .NET gelöst
In CompanyWizard rechnen alle Anbieter über eine einzige Formel. Fehlt ein Cache-Preis, gilt der Input-Preis – lieber etwas zu teuer geschätzt als Kosten verschwiegen:
public static Decimal Calculate(ModelDefinition model, String? promptCacheTtl, TurnTokenUsage tokens)
{
    var billedInput = Math.Max(0, tokens.Input - tokens.CacheRead - tokens.CacheWrite);
    var readPrice   = model.CacheReadPricePer1M ?? model.InputPricePer1M;
    var writePrice  = (promptCacheTtl == OneHourTtl ? model.CacheWrite1hPricePer1M : model.CacheWritePricePer1M)
                      ?? model.InputPricePer1M;

    return (billedInput       * model.InputPricePer1M
          + tokens.CacheRead  * readPrice
          + tokens.CacheWrite * writePrice
          + tokens.Output     * model.OutputPricePer1M) / TokensPerMillion;
}
Quelle: ModelCostCalculator.cs (Auszug)
Die Formel ist schlicht; die eigentliche Arbeit steckt davor – im Normalisieren der Usage-Felder, damit tokens.Input bei jedem Anbieter dasselbe bedeutet.
Lesson Learned: Der automatische Cache-Marker von Anthropic traf in CompanyWizard über mehrere Gesprächszüge zunächst nie: Eine Systemnachricht mit dem aktuellen Datum stand vor dem eigentlichen Systemprompt und machte jeden Präfix einzigartig. Erst ein eigener Breakpoint am Systemprompt, also ein Marker, bis zu dem Anthropic den Präfix cacht, und die Datumsnachricht dahinter brachten die Treffer.
7. Wie wir gemessen haben
- Ein Stichtag: alle Messungen am 19. Oktober 2026, mit eigenen Messschlüsseln.
- Rohes HTTP statt SDK: Jeder Aufruf ist als JSON archiviert, ohne Header und ohne Schlüssel.
- Ein Behauptungsregister: 91 Aussagen, jede mit Status (bestätigt, widerlegt, abweichend, nicht messbar, nicht gemessen) und Beleg.
- Alles nachmessbar: Skripte, Prompts, Rohdaten und Tabellen liegen unter github.com/evanto-media-ag/llm-caching-reasoning-costs.
Was bewusst offen blieb: Gemini 4 Argon war wegen eines Kontingentlimits nicht messbar. Die Admin-APIs von Anthropic (für Einzelorganisationen gesperrt) und Cortecs (kein Management-Schlüssel) haben wir nicht abgeglichen. DeepSeek haben wir nur über Router getestet, nicht über die eigene API. Und eine Messung an einem Tag ist eine Momentaufnahme. Preise und Modelle ändern sich monatlich.
Offenlegung: Evanto nutzt Cortecs als Partner für Managed AI in CompanyWizard. Die Messungen liefen über separate Messkonten; Cortecs hat die Ergebnisse vor der Veröffentlichung nicht gesehen.
8. Selbst nachmessen mit curl
Um die Wirkung selbst zu sehen, braucht man keine Programmiersprache und kein SDK, nur curl, jq und einen API-Schlüssel in einer Umgebungsvariable. Beide Beispiele verwenden unseren Testprompt aus dem Repository. Er hat rund 7 200 Tokens und liegt damit sicher über der Mindestgröße für den Cache. Mit einem kurzen Prompt würde man nichts sehen, weil darunter still nicht gecacht wird.
Die Beispiele laufen in bash oder zsh, also unter macOS und Linux, unter Windows in WSL oder Git Bash. Den Schlüssel setzt man vorher einmal pro Terminal-Sitzung, etwa mit export ANTHROPIC_API_KEY=… bzw. export XAI_API_KEY=…. Zuerst laden wir den Prompt herunter. -s unterdrückt die Fortschrittsanzeige, -O speichert die Datei als large.txt im aktuellen Verzeichnis:
curl -sO https://raw.githubusercontent.com/evanto-media-ag/llm-caching-reasoning-costs/main/prompts/large.txt
8.1 Caching und Thinking-Level bei Anthropic
Derselbe Aufruf dreimal, mit Cache-Marker am Systemprompt und wechselndem Thinking-Level:
ask() {
  jq -n --rawfile sys large.txt --arg effort "$1" '{
    model: "claude-haiku-5-5",
    max_tokens: 256,
    system: [{type: "text", text: $sys, cache_control: {type: "ephemeral"}}],
    messages: [{role: "user", content: "Reply with the single word OK."}],
    output_config: {effort: $effort}
  }' | curl -s https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    -d @- | jq '.usage'
}

ask high; ask low; ask high
Was hier passiert:
ask() { … }definiert eine Shell-Funktion namensask. Der Aufruf steht so nur einmal da und lässt sich mitask high,ask lowusw. wiederholen. Das Wort nachasklandet in$1und damit im Effort-Wert.jq -nbaut den JSON-Request.--rawfile sys large.txtliest den Prompt in die Variable$sysund maskiert dabei Anführungszeichen und Zeilenumbrüche,--arg effort "$1"übergibt den Effort-Wert. Von Hand geschriebenes JSON würde am langen Prompt scheitern.cache_control: {type: "ephemeral"}ist der Cache-Marker. Anthropic hält den Eintrag 5 Minuten, alle drei Aufrufe müssen also in dieser Zeit laufen. Für 1 Stunde lautet der Marker{type: "ephemeral", ttl: "1h"}.| curl … -d @-schickt das vonjqerzeugte JSON als Request-Body.@-heißt: Lies den Body von der Standardeingabe.anthropic-versionist bei Anthropic ein Pflicht-Header.| jq '.usage'zeigt von der Antwort nur den Usage-Block. Wer die ganze Antwort sehen will, schreibtjq ..
So sah das bei uns aus (Claude Haiku 5.5, Rohdaten vom 19.10.2026):
| Aufruf | effort |
cache_creation_input_tokens |
cache_read_input_tokens |
output_tokens |
davon thinking_tokens |
|---|---|---|---|---|---|
| 1 | high | 7 223 | 0 | 19 | 15 |
| 2 | low | 0 | 7 223 | 4 | 0 |
| 3 | high | 0 | 7 223 | 35 | 31 |
Aufruf 1 schreibt den Cache, die Aufrufe 2 und 3 lesen ihn. Der Wechsel des Thinking-Levels hat den Cache bei diesem Modell also nicht gebrochen. Die Antwort war jedes Mal „OK“, bezahlt wurden bei high trotzdem bis zu 35 Output-Tokens statt 4. Ihre Zahlen weichen um ein paar Tokens ab. Beim Thinking auch stärker: effort ist ein Richtwert, ob das Modell tatsächlich nachdenkt, entscheidet es selbst. In einem Kontrolllauf am 19.10. dachte Aufruf 1 gar nicht nach, Aufruf 3 mit 21 Thinking-Tokens.
Zum Variieren: Ohne cache_control bleibt cache_read_input_tokens bei 0. Andere Effort-Werte und die Reglernamen der übrigen Anbieter stehen in Abschnitt 2.2.
8.2 Kosten nachrechnen bei xAI
xAI cacht automatisch und meldet die Kosten in jeder Antwort. Zwei identische Aufrufe genügen:
ask_xai() {
  jq -n --rawfile sys large.txt '{
    model: "grok-4.7",
    instructions: $sys,
    input: "Reply with the single word OK.",
    max_output_tokens: 16,
    store: false
  }' | curl -s https://api.x.ai/v1/responses \
    -H "Authorization: Bearer $XAI_API_KEY" \
    -H "content-type: application/json" \
    -d @- | jq '.usage | {input_tokens, cached: .input_tokens_details.cached_tokens,
                         output_tokens, reasoning: .output_tokens_details.reasoning_tokens,
                         cost_in_usd_ticks}'
}

ask_xai; ask_xai
Neu gegenüber 8.1:
- Die Responses-API von xAI erwartet den Systemprompt als
instructionsund die Frage alsinput. store: falsesorgt dafür, dass xAI die Antwort nicht serverseitig speichert.max_output_tokens: 16begrenzt die Antwort. Die Output-Tokens lagen bei uns trotzdem darüber, weil das Reasoning hinzukommt.- Der
jq-Filter am Ende holt aus dem Usage-Block nur die fünf Werte, die man für die Nachrechnung braucht, und gibt ihnen kurze Namen.
Der zweite Aufruf meldete bei uns 5 809 Input-Tokens, davon 5 760 aus dem Cache, 65 Output-Tokens (64 davon Reasoning) und 33 680 000 Ticks. Mit den Preisen aus Abschnitt 1 lässt sich das nachrechnen:
(5 809 − 5 760) × 2,00 $ =    98 $
         5 760  × 0,50 $ = 2 880 $
            65  × 6,00 $ =   390 $
                           3 368 $ je 1 Mio. Tokens = 0,003368 $
10 Milliarden Ticks sind ein Dollar, 0,003368 $ also genau 33 680 000 Ticks. Der erste Aufruf mit kaum Cache-Treffern kostete 102 860 000 Ticks, rund dreimal so viel.
Bei anderen Anbietern ändern sich Endpunkt, Reglername und Usage-Felder, das Prinzip bleibt: Prompt zweimal schicken, Usage vergleichen, mit der Preistabelle nachrechnen. Welches Feld wo steht, zeigt Teil 3.
Fazit: fünf Regeln für realistische LLM-Kosten
- Rechnen Sie mit allen fünf Token-Arten. Input, Cache-Read, Cache-Write, Output, Reasoning.
- Caching ist kein Schalter, sondern Prompt-Architektur. Stabiles nach vorn, Veränderliches ans Ende, Mindestgröße beachten.
- Prüfen Sie Effort-Werte gegen das konkrete Modell. Ein angenommener Wert ist kein befolgter Wert.
- Pinnen Sie bei Routern den Upstream, wenn Cache oder Preis wichtig sind.
- Messen Sie selbst nach. Abschnitt 8 zeigt, wie das mit zwei curl-Aufrufen geht. Wo Anbieter Kostenfelder liefern, stimmten sie bei uns auf den Cent.
Die Serie
- Teil 1: Prompt Caching im Vergleich – was den Cache trägt und was ihn bricht
- Teil 2: Thinking-Level im Vergleich – sieben Werte, zwölf Interpretationen (erscheint demnächst)
- Teil 3: Kostentransparenz – Formeln, Feldnamen, Preisquellen (erscheint demnächst)
- Teil 4: Router im Vergleich – Cortecs, EU Router, Requesty, OpenRouter (erscheint demnächst)
Referenzen
- Messrepository: evanto-media-ag/llm-caching-reasoning-costs
- OpenAI: Prompt Caching, Pricing
- Anthropic: Prompt Caching, Pricing
- xAI: Prompt Caching, Cost Tracking
- Google: Gemini Caching, Pricing
- Cortecs: Prompt Caching · EU Router: API · Requesty: Auto-Caching
Sie planen eine KI-Anwendung und wollen die Kosten vorher realistisch einschätzen? Sprechen wir 30 Minuten über Ihren Workflow. Das Gespräch ist kostenlos, und Sie gehen mit Vorschlägen raus, die Sie direkt umsetzen können. 30-Min-Gespräch buchen
Hinweis: Artikel mit KI-Unterstützung erstellt.